Arquitecturas RAG (Retrieval Augmented Generation) con Azure AI Search
Las arquitecturas Retrieval Augmented Generation (RAG) son cruciales para superar las limitaciones de conocimiento de los modelos generativos. Esta lección detalla cómo Azure AI Search se integra como componente clave en RAG, permitiendo a los modelos acceder y utilizar información externa para generar respuestas más precisas y contextualmente relevantes.
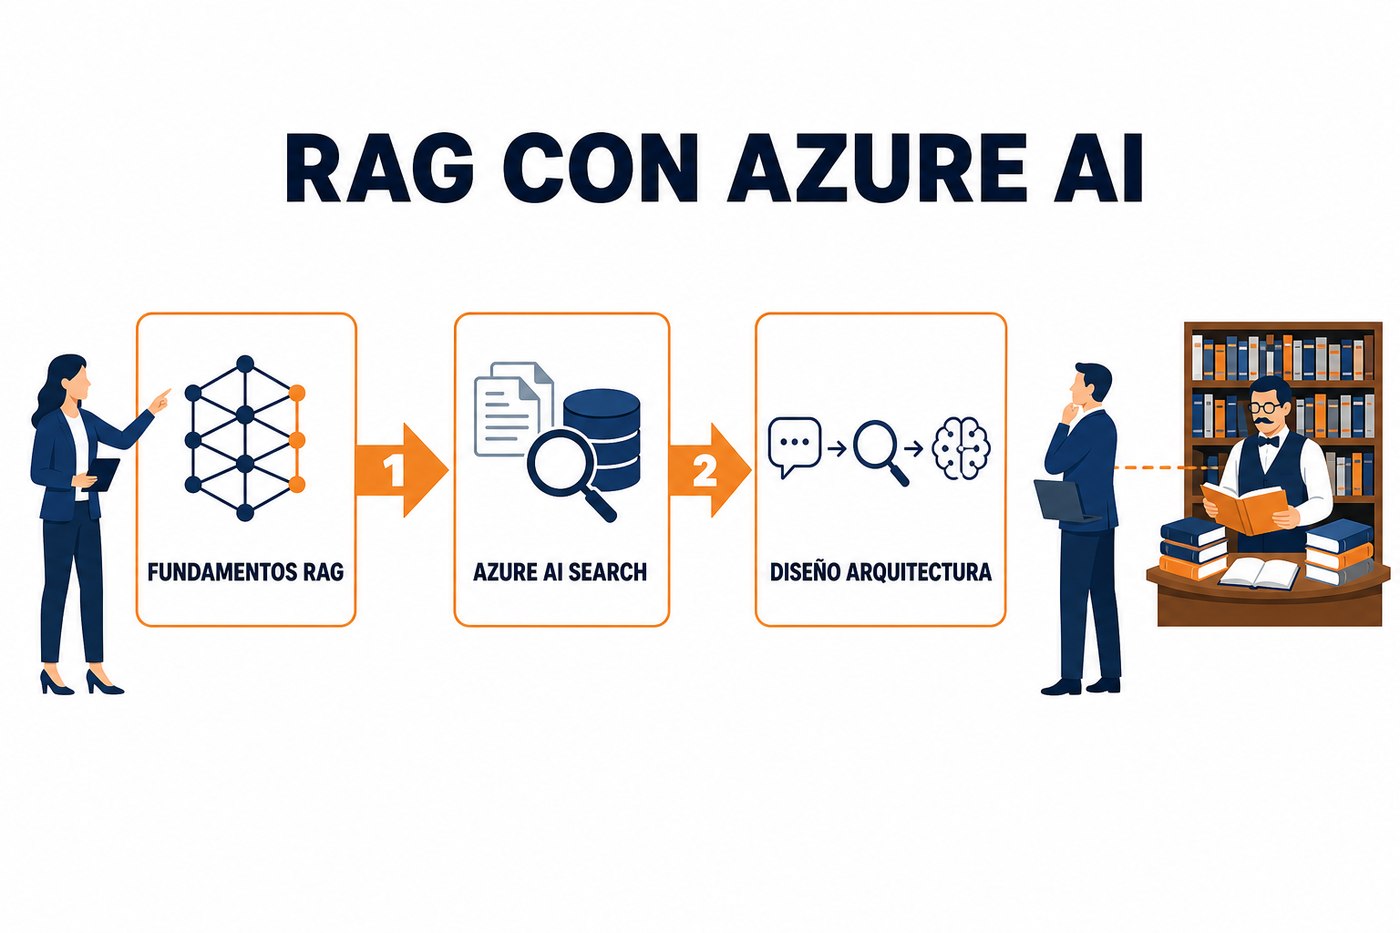
Fundamentos de RAG y su necesidad operativa
Los modelos de lenguaje grandes (LLMs) están entrenados con un corpus de datos hasta una fecha específica, lo que limita su conocimiento a esa ventana temporal. Además, su capacidad de memorización es finita, y la información específica de una organización raramente forma parte de sus datos de entrenamiento públicos. Aquí es donde RAG se vuelve indispensable. En lugar de depender únicamente del conocimiento interno del modelo, RAG le permite recuperar información relevante de una base de datos externa en tiempo real o casi real, antes de generar una respuesta.
El proceso RAG se descompone en dos fases principales:
- Recuperación (Retrieval): Dada una consulta de usuario, se busca y extrae información relevante de una base de conocimientos externa. Esta base puede ser una colección de documentos, bases de datos, APIs, etc.
- Generación (Generation): La consulta original y la información recuperada se combinan y se envían al LLM. El modelo utiliza este contexto enriquecido para generar una respuesta más informada y precisa.
Este enfoque reduce las alucinaciones (generación de información incorrecta o inventada) y permite que el modelo responda preguntas sobre datos específicos de la empresa o información actualizada que no estaba en su conjunto de entrenamiento original.
Azure AI Search como motor de recuperación
Azure AI Search (anteriormente Azure Cognitive Search) es un servicio de búsqueda en la nube que ofrece capacidades de búsqueda de texto completo, búsqueda vectorial y búsqueda híbrida sobre contenido estructurado y no estructurado. Es un componente robusto para la fase de recuperación en arquitecturas RAG debido a su escalabilidad, rendimiento y capacidades avanzadas de indexación y consulta.
Las características clave de Azure AI Search que lo hacen adecuado para RAG incluyen:
- Indexación de documentos: Permite ingerir grandes volúmenes de datos de diversas fuentes (Azure Blob Storage, Azure Data Lake Storage, etc.) y crear índices de búsqueda.
- Búsqueda de texto completo: Capacidades avanzadas para encontrar documentos relevantes basándose en palabras clave y frases.
- Búsqueda vectorial: Permite almacenar y buscar embeddings (representaciones numéricas densas) de texto, lo que es fundamental para la búsqueda semántica y la recuperación basada en similitud contextual.
- Búsqueda híbrida: Combina la búsqueda de texto completo con la búsqueda vectorial para obtener resultados más precisos, considerando tanto la coincidencia de palabras clave como la similitud semántica.
- Enriquecimiento de AI: Integración con Azure AI Services para extraer entidades, frases clave, o traducir contenido antes de la indexación, mejorando la calidad de la búsqueda.
- Filtros y facetas: Permite refinar los resultados de búsqueda con criterios específicos.
La elección entre búsqueda de texto completo, vectorial o híbrida en Azure AI Search dependerá directamente de la naturaleza de los datos y la complejidad semántica de las consultas. Para alta precisión en dominios especializados, la búsqueda híbrida con reranking es la opción más robusta.
Diseño de una arquitectura RAG con Azure AI Search
Una arquitectura RAG típica con Azure AI Search sigue estos pasos:
- Ingesta de Datos: Los documentos de la base de conocimiento (archivos PDF, documentos de Word, páginas web, etc.) se ingieren en un almacenamiento de Azure (ej. Blob Storage).
- Procesamiento y Chunking: Los documentos se dividen en fragmentos (chunks) más pequeños y manejables. Esto es crucial porque los LLMs tienen límites de tokens en su contexto de entrada. Cada chunk debe ser lo suficientemente pequeño para caber en el contexto del LLM, pero lo suficientemente grande para mantener el significado.
- Generación de Embeddings: Para cada chunk, se genera un embedding vectorial utilizando un modelo de embedding (ej. text-embedding-ada-002 de Azure OpenAI Service). Estos vectores capturan el significado semántico del texto.
- Indexación en Azure AI Search: Los chunks de texto y sus embeddings correspondientes se indexan en Azure AI Search. Se configura un índice con campos para el texto del chunk, el vector de embedding, y cualquier metadato relevante (ej. fuente, fecha).
- Consulta del Usuario: Un usuario envía una consulta a la aplicación.
- Generación de Embedding de la Consulta: La consulta del usuario también se convierte en un embedding vectorial utilizando el mismo modelo de embedding.
- Recuperación de Azure AI Search: Se realiza una consulta vectorial (o híbrida) en Azure AI Search utilizando el embedding de la consulta. Esto devuelve los chunks más relevantes de la base de conocimientos.
- Construcción del Prompt: Los chunks recuperados se insertan en un prompt junto con la consulta original del usuario. Este prompt se envía a un LLM (ej. GPT-4).
- Generación de Respuesta: El LLM utiliza la información contextual del prompt para generar una respuesta coherente y precisa.
Ejemplo de configuración de índice para RAG
Un índice de Azure AI Search para RAG podría tener la siguiente estructura de campos:
{
  "name": "my-rag-index",
  "fields": [
    {"name": "id", "type": "Edm.String", "key": true, "searchable": false, "filterable": false, "sortable": false, "facetable": false},
    {"name": "chunk_text", "type": "Edm.String", "searchable": true, "filterable": false, "sortable": false, "facetable": false},
    {"name": "chunk_vector", "type": "Collection(Edm.Single)", "searchable": true, "filterable": false, "sortable": false, "facetable": false, "vectorSearchProfile": "my-vector-profile"},
    {"name": "source_document", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": false, "facetable": true}
  ],
  "vectorSearch": {
    "profiles": [
      {"name": "my-vector-profile", "algorithmConfigurationName": "hnsw-config"}
    ],
    "algorithms": [
      {"name": "hnsw-config", "kind": "hnsw", "parameters": {"metric": "cosine", "m": 4, "efConstruction": 400, "efSearch": 500}}
    ]
  }
}
En este ejemplo, chunk_text almacena el contenido del fragmento, chunk_vector el embedding vectorial, y source_document un metadato útil para trazar la fuente de la información. La configuración de búsqueda vectorial (HNSW) optimiza la eficiencia de la búsqueda de similitud.
Ventajas y consideraciones de RAG con Azure AI Search
Ventajas:
- Precisión mejorada: Reduce las alucinaciones al anclar las respuestas en datos verificables.
- Actualización de conocimiento: Permite que los LLMs accedan a la información más reciente sin necesidad de reentrenamiento.
- Control sobre la fuente: Facilita la trazabilidad de la información utilizada para generar una respuesta.
- Reducción de costos de entrenamiento: Evita la necesidad de fine-tuning extensivo para incorporar nuevos datos.
- Escalabilidad: Azure AI Search maneja grandes volúmenes de datos y consultas de manera eficiente.
Consideraciones:
- Calidad de los datos: La efectividad de RAG depende directamente de la calidad y relevancia de los documentos en la base de conocimientos.
- Estrategia de chunking: Elegir el tamaño y la superposición adecuados para los chunks es crítico para la recuperación.
- Modelo de embedding: La selección de un modelo de embedding apropiado impacta la calidad de la búsqueda semántica.
- Latencia: La fase de recuperación añade latencia al proceso de generación de respuestas. Optimizar la búsqueda es clave.
- Gestión de costos: Los costos de Azure AI Search y los servicios de embedding deben ser monitoreados y gestionados.
Aplicación práctica: Preparación para el lunes
Para aplicar los conceptos de esta lección, identifique un conjunto de documentos internos (manuales, políticas, FAQs) que podrían beneficiarse de una interfaz de preguntas y respuestas basada en RAG. Considere lo siguiente:
- Selección de datos: Elija 5-10 documentos PDF o DOCX que representen un dominio de conocimiento específico.
- Estrategia de chunking: Piense cómo dividiría estos documentos. ¿Sería por párrafo, por sección, o por un número fijo de tokens? Considere el contexto necesario para que un chunk sea significativo por sí solo.
- Servicio de embedding: Familiarícese con la API de Azure OpenAI Service para generar embeddings. Puede usar el modelo text-embedding-ada-002.
- Esquema de índice: Diseñe un esquema inicial para su índice de Azure AI Search, incluyendo campos para el texto del chunk, el vector de embedding y cualquier metadato útil (ej. título del documento original, URL si aplica).
- Simulación de consulta: Imagine 3-5 preguntas que un usuario haría sobre esos documentos. ¿Cómo esperaría que la búsqueda vectorial o híbrida recuperara los chunks correctos?
Este ejercicio le permitirá visualizar la infraestructura necesaria y los desafíos de procesamiento de datos para implementar un sistema RAG funcional.
There are no comments for now.
to be the first to leave a comment.