Ingeniería de Prompts para Gemini
La ingeniería de prompts es fundamental para interactuar eficazmente con Gemini. Permite obtener respuestas precisas y controladas, optimizando el rendimiento del modelo para tareas específicas. Dominar estas técnicas es clave para la aplicación práctica de Gemini en sus proyectos.
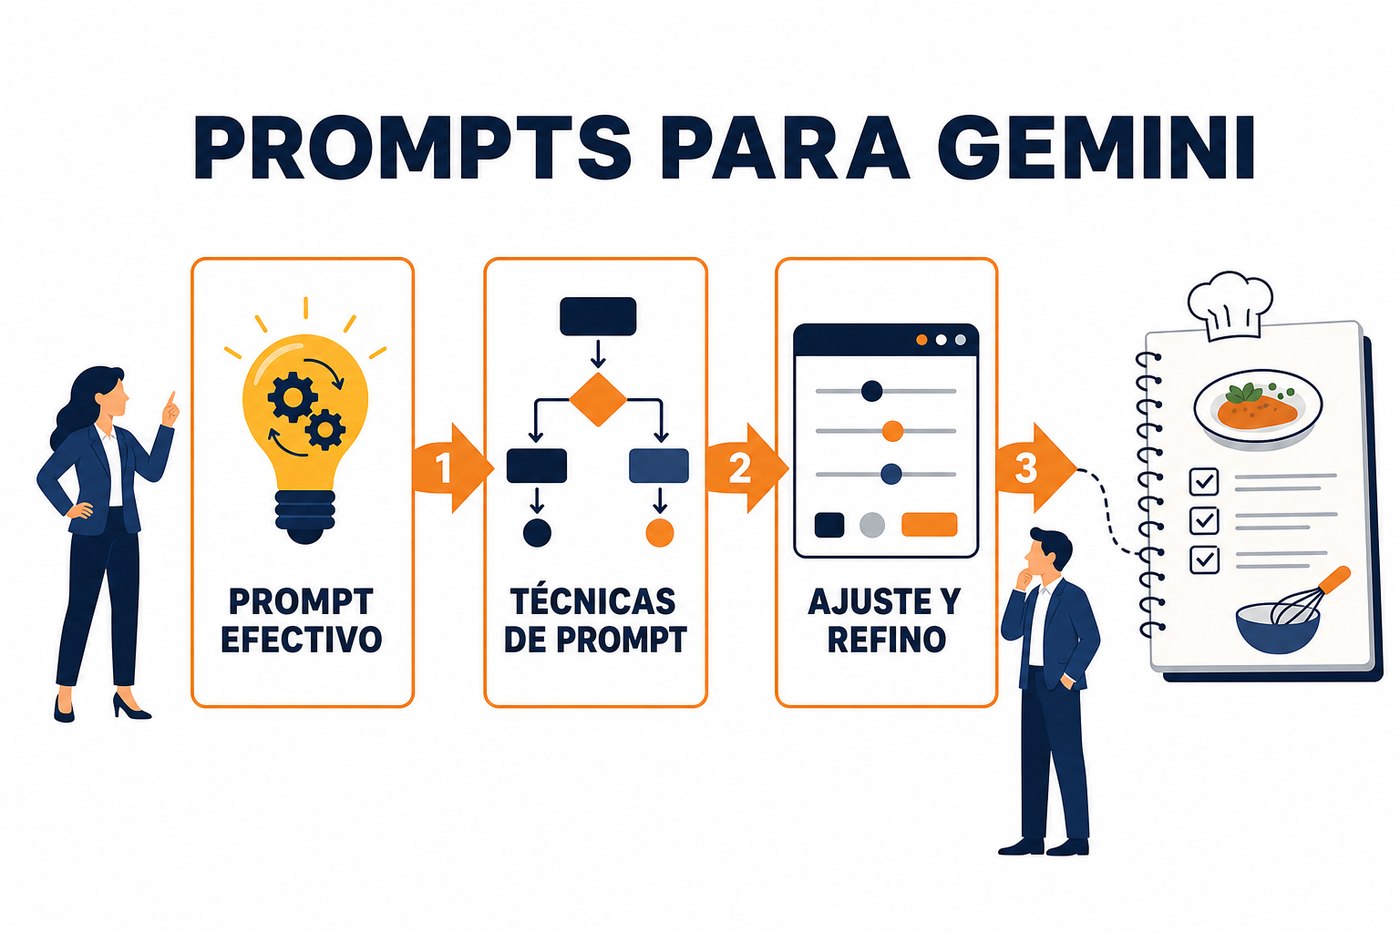
Principios de un prompt efectivo
Un prompt efectivo es claro, conciso y específico. Su objetivo es minimizar la ambigüedad y guiar al modelo hacia la respuesta deseada. La calidad del output de Gemini depende directamente de la calidad del input que se le proporciona. No se trata solo de qué preguntar, sino de cómo formular la pregunta y el contexto.
- Claridad y Especificidad: Evitar lenguaje vago. Indicar explícitamente qué tipo de información se espera y en qué formato.
- Contexto Relevante: Proporcionar la información necesaria para que el modelo entienda la tarea. Esto puede incluir datos de entrada, antecedentes o el rol que debe asumir el modelo.
- Instrucciones Claras: Detallar la tarea paso a paso si es compleja. Indicar restricciones, longitud deseada o tono de la respuesta.
- Formato de Salida: Especificar si se requiere JSON, una lista, un párrafo, etc. Esto es crítico para la integración con sistemas downstream.
Técnicas de 'Few-Shot Prompting'
El few-shot prompting implica proporcionar al modelo algunos ejemplos de pares entrada-salida. Esto le permite aprender el patrón deseado y replicarlo en nuevas entradas, sin necesidad de un reentrenamiento completo. Es particularmente útil para tareas de clasificación, extracción de información o reescritura con un estilo específico.
Cuando se usa few-shot prompting, los ejemplos deben ser representativos y variados, pero consistentes en el formato y el tipo de tarea. Un buen conjunto de ejemplos reduce la probabilidad de que el modelo "alucine" o genere respuestas fuera de las expectativas.
prompt = """
Clasifica el sentimiento de los siguientes comentarios:

Comentario: "Me encanta este producto, funciona perfecto."
Sentimiento: Positivo

Comentario: "El servicio al cliente fue terrible, no me ayudaron."
Sentimiento: Negativo

Comentario: "Funciona, pero podría ser mejor."
Sentimiento: Neutro

Comentario: "La interfaz es muy intuitiva y rápida."
Sentimiento:"Para el few-shot prompting, la calidad y relevancia de los ejemplos es más importante que la cantidad. Tres a cinco ejemplos bien seleccionados suelen ser más efectivos que diez ejemplos mediocres o redundantes. Priorice la diversidad de casos dentro de la tarea.
Ajuste de parámetros de generación
Además de la formulación del prompt, los parámetros de generación influyen significativamente en la salida del modelo. Estos se configuran a través de la API o la interfaz de Vertex AI y permiten controlar aspectos como la creatividad, la longitud y la diversidad de las respuestas.
- Temperatura (Temperature): Controla la aleatoriedad de la salida. Un valor más alto (ej. 0.8-1.0) produce respuestas más creativas y diversas, pero potencialmente menos coherentes. Un valor más bajo (ej. 0.0-0.3) genera respuestas más deterministas y enfocadas, útiles para tareas donde la precisión es crítica.
- Top-K: Limita la selección de la siguiente palabra a las k palabras más probables. Reduce la probabilidad de generar palabras poco comunes, aumentando la coherencia.
- Top-P (Nucleus Sampling): Selecciona la siguiente palabra de un conjunto de palabras cuya probabilidad acumulada alcanza el valor de p. Ofrece un control más dinámico sobre la diversidad que Top-K.
- Max Output Tokens: Define la longitud máxima de la respuesta generada por el modelo. Es crucial para controlar el costo y asegurar que la respuesta se ajuste a los requisitos del sistema downstream.
- Stop Sequences: Cadenas de texto que, al ser generadas por el modelo, indican que debe detenerse. Útil para controlar el fin de la respuesta o para generar listas con un formato específico.
| Parámetro | Efecto de valor bajo | Efecto de valor alto |
|---|---|---|
| Temperatura | Respuestas predecibles, conservadoras | Respuestas creativas, diversas |
| Max Output Tokens | Respuestas cortas, concisas | Respuestas largas, detalladas |
Iteración y refinamiento de prompts
La ingeniería de prompts es un proceso iterativo. Es raro obtener la respuesta perfecta en el primer intento. Se requiere experimentar, analizar las salidas del modelo y ajustar el prompt o los parámetros de generación. Se recomienda mantener un registro de los prompts y sus resultados para identificar patrones y mejoras.
- Definir el Objetivo: Clarificar qué se espera del modelo.
- Crear el Prompt Inicial: Basado en los principios de claridad y contexto.
- Generar y Evaluar: Ejecutar el prompt y analizar la respuesta. ¿Es precisa? ¿Completa? ¿En el formato correcto?
- Identificar Desviaciones: Si la respuesta no es la esperada, determinar qué aspecto del prompt o parámetro podría estar causando el problema.
- Modificar y Repetir: Ajustar el prompt (añadir contexto, ejemplos, restricciones) o los parámetros (temperatura, max tokens) y volver a evaluar.
Aplicación práctica: ¿Qué hacer el lunes?
El lunes, seleccione una tarea recurrente en su equipo que involucre procesamiento de texto (ej. resumir correos, clasificar tickets de soporte, extraer información de documentos). Utilice la consola de Vertex AI o la API para experimentar con Gemini.
- Diseñe un prompt inicial para la tarea, enfocándose en la claridad de la instrucción y el formato de salida deseado.
- Aplique few-shot prompting si la tarea lo permite, agregando 2-3 ejemplos representativos de entrada-salida.
- Experimente con los parámetros de generación: Pruebe a variar la temperatura entre 0.2 y 0.8 para observar cómo afecta la creatividad y la coherencia de las respuestas. Ajuste 'Max Output Tokens' para controlar la longitud.
- Documente sus hallazgos: Anote qué prompts y parámetros producen los mejores resultados para su caso de uso. Esta documentación será la base para futuras automatizaciones o integraciones.
There are no comments for now.
to be the first to leave a comment.