Manejo de Errores en Workflows
La automatización con n8n busca eficiencia, pero los fallos son inevitables. Esta lección cubre las estrategias básicas para el manejo de errores, permitiendo que sus workflows reaccionen de forma controlada ante problemas. Aprenderá a configurar notificaciones para fallos críticos, asegurando la visibilidad y acción oportuna.
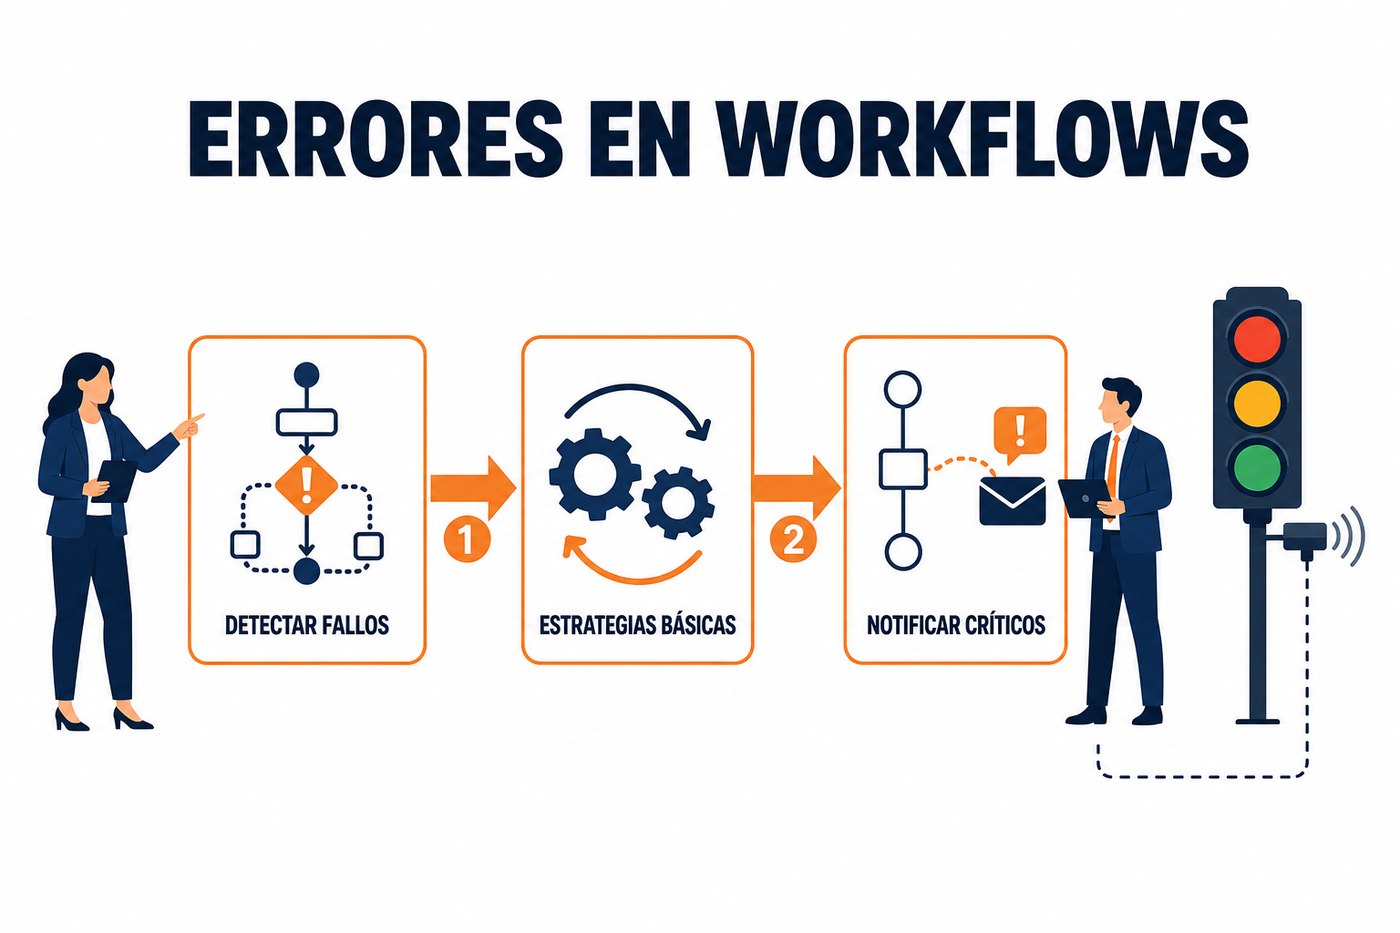
La importancia del manejo de errores en automatización
Un workflow es tan robusto como su capacidad para manejar situaciones inesperadas. Sin un manejo de errores adecuado, un fallo en cualquier nodo puede detener la ejecución completa, dejando procesos incompletos y datos inconsistentes. Implementar estrategias de manejo de errores permite que los workflows continúen su ejecución por rutas alternativas, registren el problema o notifiquen a un responsable, minimizando el impacto operativo.
Tipos de errores y su impacto
En n8n, los errores pueden clasificarse en varias categorías, cada una con un impacto distinto:
- Errores de conexión o autenticación: Fallos al comunicarse con un servicio externo (API no disponible, credenciales incorrectas). Impacto: El nodo afectado no puede realizar su operación.
- Errores de datos: Datos de entrada inesperados o malformados que un nodo no puede procesar (ej. un campo numérico recibe texto). Impacto: El nodo falla al intentar procesar el item.
- Errores de lógica: Condiciones no contempladas en el diseño del workflow (ej. un archivo esperado no existe). Impacto: El flujo toma una ruta incorrecta o se detiene.
- Errores de servicio: Problemas internos del servicio al que se conecta n8n (ej. límite de tasa excedido, error 5xx). Impacto: Operación del nodo fallida.
Cada uno de estos errores requiere una respuesta. Para algunos, un simple reintento puede ser suficiente. Para otros, se necesita una intervención humana o una lógica de compensación.
Configuración básica de manejo de errores en n8n
n8n ofrece mecanismos para controlar cómo se comportan los nodos ante errores. La configuración más fundamental se encuentra en la sección Error Handling de cada nodo.
- Continue On Fail: Si está habilitado, el nodo no detendrá el workflow si falla. En su lugar, el item que causó el error se marcará como "fallido" y pasará al siguiente nodo, pero con una propiedad
_errorque describe el fallo. Los items que no fallaron continuarán normalmente. Útil para procesar lotes donde algunos ítems pueden fallar sin detener todo el proceso. - Retry On Fail: Permite que el nodo intente la operación varias veces si falla. Puede configurarse el número de reintentos y el intervalo entre ellos. Ideal para errores transitorios como problemas de red o límites de tasa temporales.
Además de estas configuraciones por nodo, n8n permite crear una rama de manejo de errores global para un workflow. Esto se logra conectando un nodo directamente desde el icono de error de un nodo (el círculo rojo que aparece cuando un nodo falla). Esta rama se ejecutará solo cuando el nodo conectado falle.
No use 'Continue On Fail' indiscriminadamente. Si un error es crítico para la integridad de los datos o la lógica del negocio, el workflow debe detenerse o ejecutar una rama de compensación explícita, no simplemente ignorar el fallo. Evalúe el impacto de cada error antes de decidir continuar.
Notificación de errores críticos
Para errores que requieren atención inmediata, la notificación es clave. Un patrón común es enviar un mensaje a un canal de comunicación (Slack, Teams, correo electrónico) con detalles del fallo.
Pasos para configurar una notificación de error simple:
- Identifique el nodo crítico: Determine qué nodos, si fallan, necesitan una notificación inmediata.
- Conecte un nodo de notificación: Desde el puerto de error del nodo crítico, arrastre una conexión a un nodo de notificación. Por ejemplo, un nodo 'Send Email' o 'Slack'.
- Construya el mensaje de error: Utilice expresiones para incluir detalles relevantes del error en el mensaje. El objeto
_errordel item fallido contiene información como_error.message,_error.stacky_error.code. También puede incluir el nombre del workflow ({{ $workflow.name }}) y el ID de la ejecución ({{ $workflow.id }}). - Pruebe el manejo de errores: Provoque intencionalmente un fallo en el nodo crítico para verificar que la notificación se envía correctamente y contiene la información esperada.
Ejemplo de expresión para un mensaje de Slack:
{"text": "🚨 Error en workflow \"{{ $workflow.name }}\".\nNodo: {{ $node.name }}\nMensaje: {{ $json._error.message }}\nEjecución ID: {{ $workflow.id }}"}Aplicación práctica: Monitoreo de fallos en su workflow
El lunes, revise uno de sus workflows existentes en n8n que interactúe con un servicio externo (ej. HTTP Request, Google Sheets, CRM). Identifique un nodo que, si falla, requeriría su intervención. Configure un manejo de errores básico para ese nodo, siguiendo estos pasos:
- Seleccione un nodo crítico: Elija un nodo que realice una operación fundamental, como una inserción de datos o una llamada a una API.
- Añada una rama de error: Conecte un nodo de notificación (ej. Email o Slack) desde el puerto de error del nodo crítico.
- Configure el mensaje de notificación: Utilice las expresiones aprendidas para incluir el nombre del workflow, el nombre del nodo que falló y el mensaje de error en la notificación.
- Pruebe el flujo: Desactive temporalmente las credenciales del nodo crítico o modifique una URL para forzar un fallo y verifique que recibe la notificación de error correctamente. Asegúrese de revertir los cambios después de la prueba.
There are no comments for now.
to be the first to leave a comment.