Manejo de errores y reintentos en grafos
La robustez de un agente LangGraph en producción depende de su capacidad para manejar fallos. Esta lección cubre la implementación de mecanismos de tolerancia a errores y reintentos dentro de la definición de un grafo, asegurando la continuidad operativa y la fiabilidad del sistema frente a interrupciones o respuestas inesperadas de herramientas y modelos.
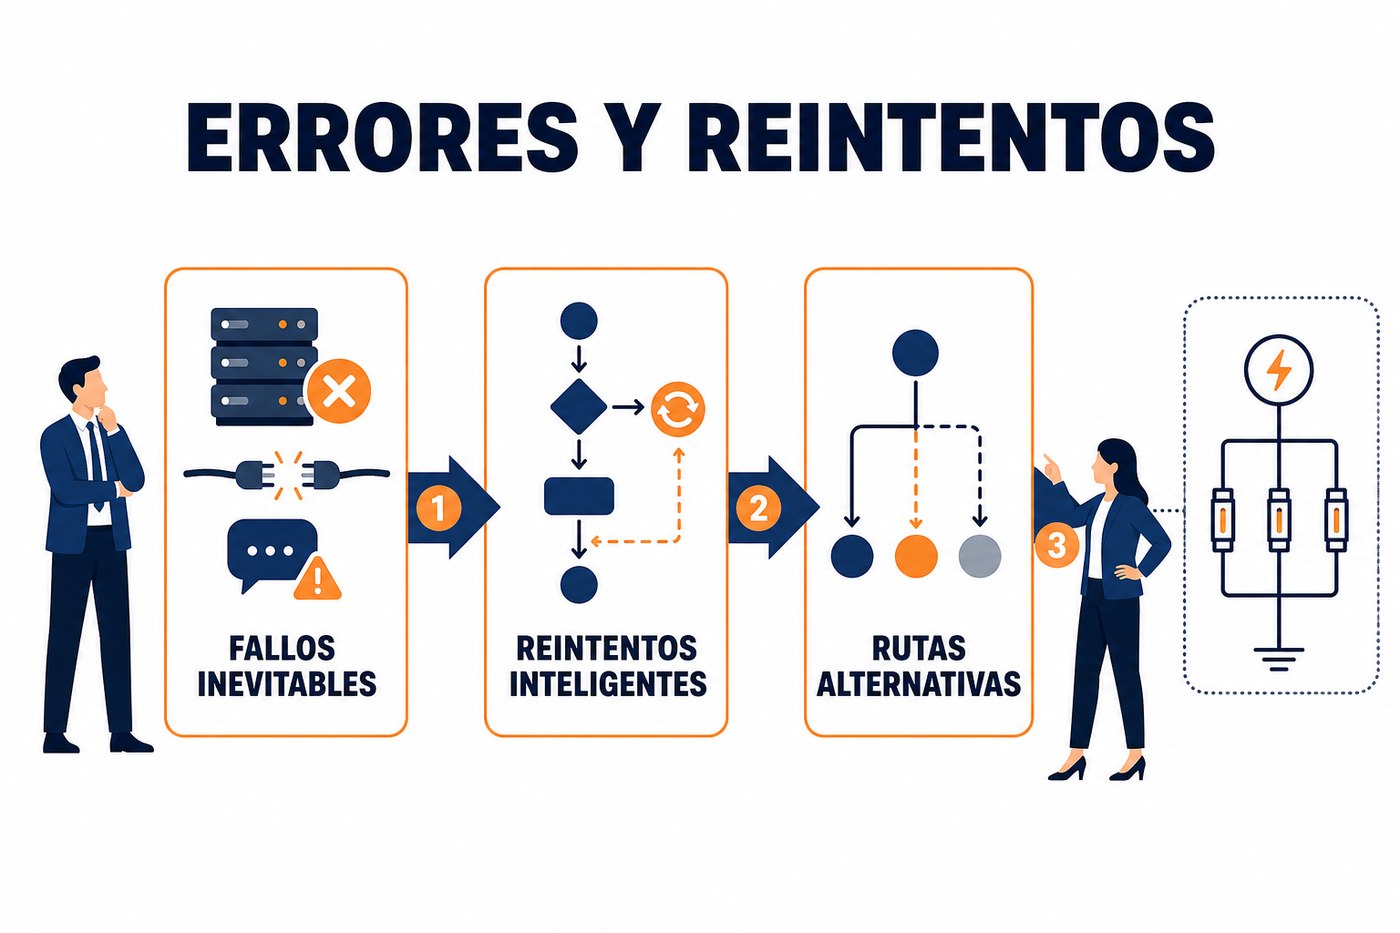
La inevitabilidad del error en sistemas distribuidos
Los agentes LangGraph interactúan con múltiples servicios externos: Modelos de Lenguaje Grandes (LLMs), bases de datos, APIs de herramientas, y sistemas de almacenamiento. Cada una de estas interacciones es un punto potencial de fallo. Un LLM puede devolver una respuesta malformada, una API puede estar temporalmente no disponible, o una herramienta puede generar una excepción inesperada. Ignorar estos escenarios lleva a agentes frágiles que se detienen ante la primera anomalía, degradando la experiencia del usuario y la utilidad del sistema.
Implementar un manejo de errores robusto no es una característica opcional, sino un requisito fundamental para cualquier sistema en producción. Permite que el grafo se recupere de fallos transitorios y, en caso de fallos persistentes, que degrade la funcionalidad de manera controlada o notifique adecuadamente para intervención manual.
Estrategias de reintento en nodos LangGraph
LangGraph, al ser una capa sobre LangChain, hereda algunas de sus capacidades de manejo de errores, pero la estructura de grafo permite un control más granular. Los reintentos son la primera línea de defensa contra fallos transitorios. Se aplican típicamente a interacciones con LLMs o llamadas a herramientas externas.
Existen dos enfoques principales para implementar reintentos:
- Reintentos a nivel de invocación de herramienta/LLM: Muchas bibliotecas de cliente para LLMs (ej. OpenAI Python SDK) y para APIs HTTP (ej. requests con urllib3.Retry) ofrecen mecanismos de reintento integrados. Es la forma más sencilla y eficiente de manejar fallos específicos de la comunicación o del servicio. Se configura al inicializar la herramienta o el cliente.
- Reintentos a nivel de nodo LangGraph: Si un nodo ejecuta lógica más compleja que puede fallar por razones internas (ej. procesamiento de datos, lógica de negocio), o si la herramienta no ofrece reintentos integrados, se puede envolver la lógica del nodo en un bloque try-except y usar una biblioteca como tenacity para manejar los reintentos. Esto permite un control más fino sobre el número de reintentos, el retraso entre ellos (exponencial o fijo) y las excepciones a capturar.
Un reintento exponencial con jitter (aleatoriedad) es preferible a un retraso fijo. Evita que múltiples instancias del agente saturen un servicio externo que acaba de recuperarse, distribuyendo la carga de reintentos.
from tenacity import retry, stop_after_attempt, wait_exponential

@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=4, max=10))
def call_llm_with_retry(prompt):
    # Simula una llamada a LLM que puede fallar
    import random
    if random.random() < 0.6: # 60% de probabilidad de fallo
        raise ValueError("LLM temporalmente no disponible")
    return f"Respuesta para: {prompt}"

def llm_node(state):
    prompt = state["messages"][-1].content
    try:
        result = call_llm_with_retry(prompt)
        return {"messages": [("ai", result)]}
    except Exception as e:
        print(f"Fallo persistente en LLM: {e}")
        return {"error": str(e), "messages": [("ai", "Lo siento, no pude procesar tu solicitud.")]}
Manejo de excepciones y estados de error en el grafo
Más allá de los reintentos, es crucial definir cómo el grafo reacciona a los fallos persistentes o a excepciones no recuperables. LangGraph permite modelar explícitamente rutas de error.
- Transiciones condicionales por error: Un nodo puede retornar un estado que indique un error (ej. {"error": "mensaje de error"}). Las aristas condicionales pueden entonces dirigir el flujo a un nodo de manejo de errores en lugar de continuar con la lógica principal. Este nodo de error podría registrar el problema, notificar a un sistema de monitoreo, o generar una respuesta de fallback para el usuario.
- Propagación de excepciones: Si una excepción no es capturada dentro de un nodo, se propagará hacia arriba, deteniendo la ejecución del grafo. Esto es aceptable para errores críticos que requieren atención inmediata, pero debe ser una decisión consciente y no un descuido.
El estado del grafo es fundamental aquí. Si un nodo falla, el estado debe reflejarlo adecuadamente para que los nodos subsiguientes o las transiciones condicionales puedan actuar. Esto puede incluir añadir un campo error al estado, o modificar el tipo de mensaje para indicar un fallo.
Diseño de rutas de fallback y degradación controlada
Un agente robusto no solo maneja errores, sino que también puede ofrecer una funcionalidad reducida o alternativa cuando los servicios principales fallan. Esto se conoce como degradación controlada o fallback.
- Nodos de fallback: Diseñe nodos específicos que se activen cuando una ruta principal falle. Por ejemplo, si un LLM avanzado falla, el grafo podría transicionar a un nodo que utilice un LLM más simple y económico, o que genere una respuesta predefinida de "no puedo ayudarte en este momento".
- Respuestas predefinidas: Para fallos críticos donde no hay una alternativa viable, es mejor proporcionar una respuesta útil que un error técnico. Un nodo de error final podría simplemente decir "Hubo un problema con mi sistema, por favor inténtalo más tarde" y registrar el incidente.
- Caché de respuestas: En algunos casos, si una herramienta o LLM falla, se podría intentar servir una respuesta de una caché reciente si la consulta es similar. Esto no es un reemplazo completo, pero puede mejorar la resiliencia percibida.
Consideraciones de seguridad y auditoría
El manejo de errores tiene implicaciones de seguridad y auditoría. Los mensajes de error no deben exponer información sensible del sistema, como rutas de archivos, credenciales o detalles internos de la infraestructura. Los mensajes para el usuario final deben ser claros y no técnicos.
- Registro de errores: Es vital registrar todos los errores detalladamente en los logs para su posterior análisis. Esto incluye el tipo de excepción, el stack trace, el estado relevante del grafo (sin datos sensibles), y el momento del fallo. Estos logs alimentarán los sistemas de monitoreo y alerta.
- Auditoría de reintentos: Registrar cuándo y por qué se producen los reintentos puede ayudar a identificar servicios externos inestables o patrones de fallo recurrentes que requieren una investigación más profunda.
- Alertas: Configure alertas para fallos persistentes o para un umbral de errores que indique un problema sistémico. Esto permite una respuesta proactiva por parte del equipo de operaciones.
Aplicación práctica: ¿Qué hacer el lunes?
Revise los nodos críticos de sus grafos LangGraph que interactúan con servicios externos (LLMs, APIs de herramientas). Identifique los puntos de fallo más probables.
- Implemente reintentos: Para llamadas a LLMs y herramientas, use los mecanismos de reintento de las bibliotecas subyacentes (ej. SDK de OpenAI) o envuelva la lógica del nodo con tenacity, configurando un retraso exponencial con jitter y un número máximo de reintentos razonable (típicamente 3-5).
- Defina estados de error: Modifique el esquema de estado de su grafo para incluir un campo error. Cuando un nodo falle persistentemente, actualice este campo con un mensaje de error conciso y no técnico.
- Cree rutas de fallback: Añada transiciones condicionales que, al detectar un estado de error, dirijan el flujo a un nodo de manejo de errores o a un nodo que proporcione una respuesta de fallback. Asegúrese de que este nodo registre el error completo internamente.
- Pruebe los fallos: Simule fallos de servicios externos en su entorno de desarrollo/pruebas para verificar que los mecanismos de reintento y manejo de errores funcionan como se espera y que las rutas de fallback se activan correctamente. Verifique los logs generados.
There are no comments for now.
to be the first to leave a comment.