Monitoreo y logs
Si no lo mides, no lo controlas. Monitoreo = saber si el servicio está sano antes de que el usuario se queje.
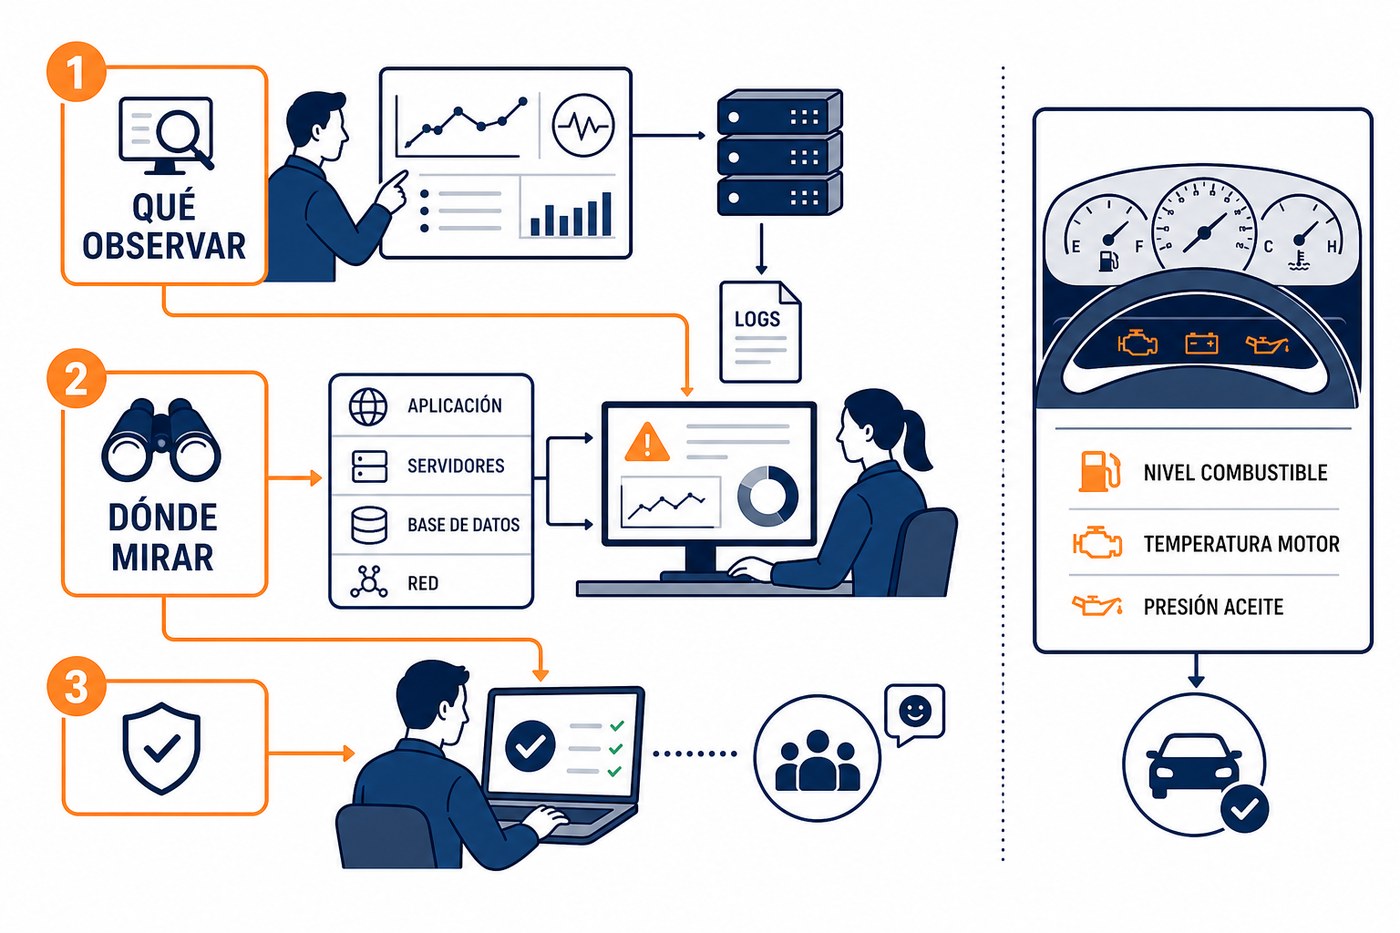
Qué observar
- Recursos: CPU, RAM, disco y GPU/VRAM.
- Salud del servicio: responde HTTP 200? latencia?
- Errores: tasa de 5xx, excepciones en logs.
- Costos: consumo de APIs y crédito restante.
Dónde mirar
journalctl -u servicioydocker logs.- Logs de nginx:
access.logyerror.log. - Un script que revisa y avisa a Discord si algo baja de umbral.
EN INT
el cron intranet-status-30m revisa avance de cursos, saldo de APIs y alerta si el crédito baja. Proactivo > reactivo.
Rating
There are no comments for now.
to be the first to leave a comment.