Tokens, contexto y temperatura
Tres conceptos prácticos que todo usuario de LLM debe dominar para controlar la salida.
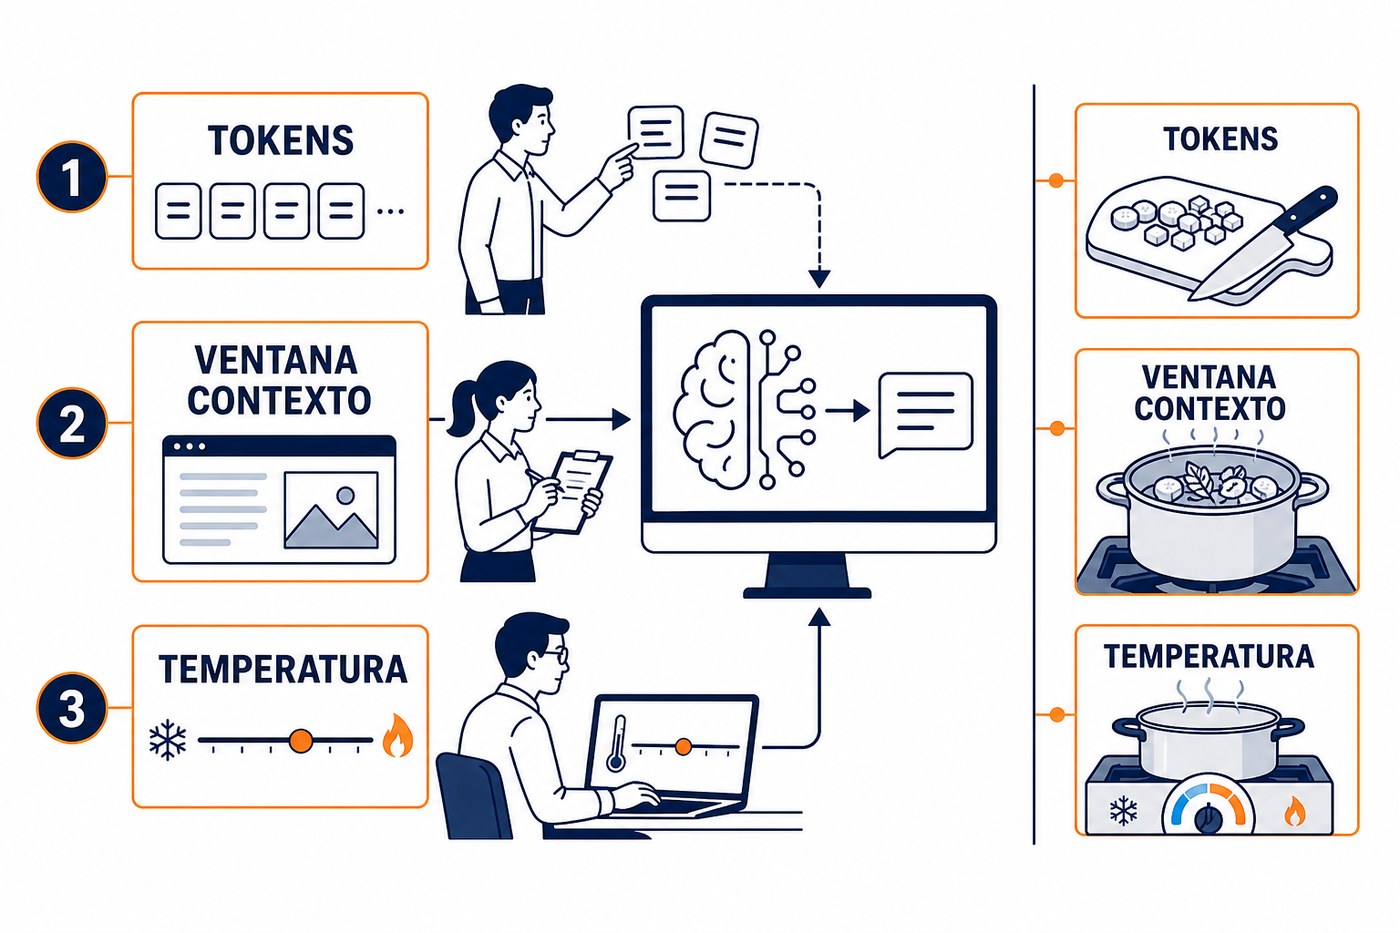
Tokens
- Un token ≈ una palabra corta o fragmento de palabra (~4 caracteres en español/inglés).
- Los modelos cobran y limitan por tokens (entrada + salida).
- Una conversación larga consume ventana de contexto (ej. 128k tokens).
Ventana de contexto
Es la "memoria de trabajo" del modelo: cuántos tokens puede ver a la vez. Si la excedes, se pierde información antigua.
Temperatura
- Controla la aleatoriedad de la salida (0 a 2).
- Baja (0–0.3): respuestas deterministas, buenas para hechos y código.
- Alta (0.7–1.0): más creativo y variado, bueno para lluvia de ideas.
REGLA PRÁCTICA
tareas objetivas → temperatura baja. Tareas creativas → temperatura alta.
Rating
There are no comments for now.
to be the first to leave a comment.