Creación y gestión de datasets de prueba
La evaluación sistemática de agentes LangGraph requiere datasets de prueba representativos. Estos datasets son la base para medir el rendimiento, identificar regresiones y asegurar la calidad del agente en producción. Esta lección cubre el diseño, la construcción y la gestión de estos conjuntos de datos.
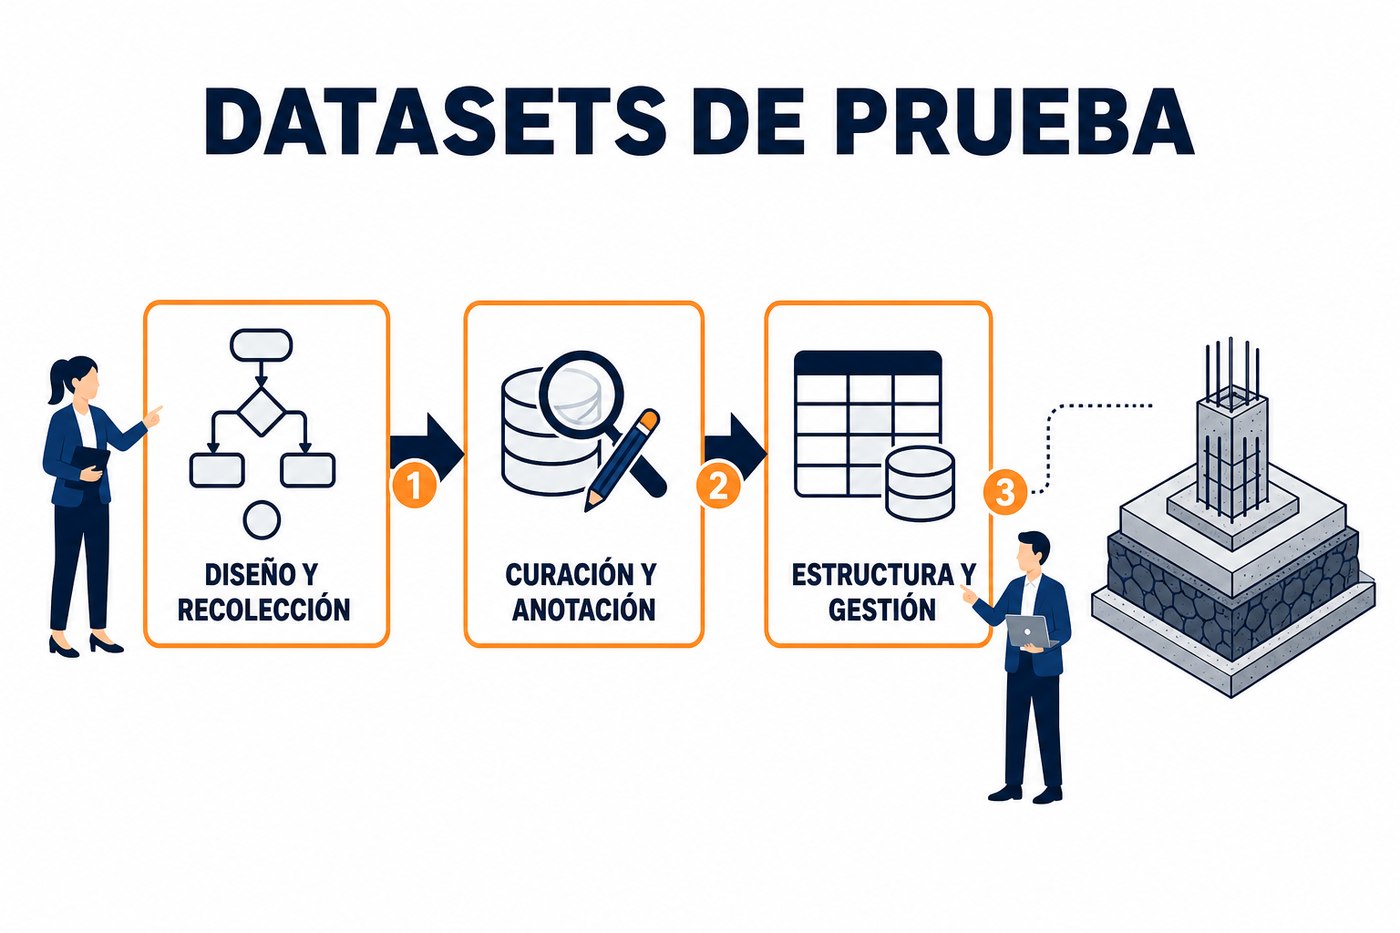
Propósito de los datasets de prueba en LangGraph
Los datasets de prueba no son solo un conjunto de ejemplos; son una herramienta de validación crítica. Su objetivo es simular el entorno operativo del agente y verificar que el comportamiento esperado se mantenga en diversas condiciones. Un dataset bien diseñado permite:
- Medir el rendimiento: Cuantificar la precisión, relevancia y completitud de las respuestas del agente.
- Identificar casos borde: Descubrir escenarios donde el agente falla o se comporta de manera inesperada.
- Detectar regresiones: Asegurar que los cambios en el grafo o en los modelos subyacentes no degraden el rendimiento en casos previamente resueltos.
- Comparar versiones: Evaluar objetivamente el impacto de nuevas iteraciones del agente.
La calidad del dataset impacta directamente la validez de las métricas de evaluación. Un dataset pobre o sesgado conducirá a una comprensión incompleta o engañosa del rendimiento real del agente.
Diseño y recolección de ejemplos
La construcción de un dataset comienza con la definición de los tipos de interacciones que el agente debe manejar. Esto implica entender el dominio del problema y las expectativas del usuario final. La recolección debe ser un proceso iterativo y representativo.
- Identificación de fuentes: Recopilar ejemplos de interacciones reales (si están disponibles y anonimizadas), logs de sistemas existentes, o simular conversaciones con usuarios representativos. Para agentes internos, esto puede incluir solicitudes comunes de ingenieros o personal administrativo.
- Variedad de entradas: Incluir preguntas directas, indirectas, ambiguas, con errores tipográficos, con información faltante o redundante. Variar la longitud, el estilo y la complejidad del lenguaje.
- Casos de éxito y fallo: Es crucial incluir ejemplos donde el agente se espera que funcione correctamente (casos positivos) y donde se espera que falle o requiera aclaración (casos negativos o de fallo controlado).
- Diversidad de trayectorias: Para LangGraph, esto significa incluir ejemplos que ejerciten diferentes rutas dentro del grafo. Por ejemplo, si un agente tiene una rama para búsqueda de información y otra para análisis de datos, el dataset debe contener ejemplos para ambas.
- Evolución del dataset: A medida que el agente se desarrolla y se identifican nuevos patrones de fallo, el dataset debe actualizarse con esos nuevos ejemplos. Los errores en producción son una fuente valiosa para expandir el dataset de prueba.
Prioriza la representatividad sobre la cantidad. Un dataset pequeño pero que cubra los escenarios clave y los casos borde será más útil que uno grande y redundante. La calidad de cada ejemplo es fundamental.
Curación y anotación de datos
Una vez recolectados los ejemplos, es necesario curarlos y anotarlos. La curación implica limpiar los datos, eliminar duplicados y asegurar la coherencia. La anotación consiste en asociar cada entrada con la salida esperada y, opcionalmente, con la trayectoria esperada del grafo.
- Definición de salidas esperadas: Para cada entrada, se debe especificar la respuesta correcta o el comportamiento deseado del agente. Esto puede ser una respuesta textual, una acción específica (ej. llamar a una herramienta), o una combinación.
- Anotación de trayectorias (opcional pero recomendable): Para agentes LangGraph, puede ser útil anotar la secuencia de nodos que el agente debería ejecutar para una entrada dada. Esto facilita la depuración y la evaluación de la lógica interna del grafo.
- Consistencia: Asegurar que las anotaciones sean consistentes a lo largo de todo el dataset. Múltiples anotadores deben seguir las mismas directrices.
- Herramientas de anotación: Para datasets grandes, considerar el uso de herramientas de anotación de datos que permitan a los expertos de dominio etiquetar ejemplos de manera eficiente. Para equipos pequeños, hojas de cálculo bien estructuradas pueden ser suficientes.
Estructura de un dataset de prueba
Un dataset de prueba para LangGraph debe ser una colección estructurada de pares de entrada/salida. Aunque el formato exacto puede variar, una estructura común es un archivo CSV o JSON donde cada registro representa un caso de prueba.
| Campo | Descripción | Ejemplo |
|---|---|---|
input_query | La consulta o entrada del usuario al agente. | "Necesito el reporte de ventas del Q3 2023." |
expected_output | La respuesta o resultado esperado del agente. | "Aquí está el reporte de ventas consolidado para el tercer trimestre de 2023." |
expected_action | Si aplica, la acción específica o llamada a herramienta esperada. | "call_tool(get_sales_report, {'quarter': 'Q3', 'year': 2023})" |
expected_trajectory | Secuencia de nodos esperada en el grafo (opcional). | "[start, route_to_tool, execute_tool, format_response, end]" |
test_case_id | Identificador único para el caso de prueba. | "SALES_REPORT_001" |
category | Categoría o tipo de consulta para análisis agrupado. | "Reportes Financieros" |
[
  {
    "test_case_id": "SUPPORT_001",
    "input_query": "Mi conexión a internet no funciona.",
    "expected_output": "Por favor, reinicie su router y verifique los cables.",
    "expected_action": "suggest_troubleshooting_steps",
    "expected_trajectory": ["start", "diagnose_issue", "provide_solution", "end"],
    "category": "Soporte Técnico"
  },
  {
    "test_case_id": "SALES_002",
    "input_query": "¿Cuál fue la facturación del último mes?",
    "expected_output": "Necesito saber a qué mes te refieres para darte la facturación. ¿Podrías especificarlo?",
    "expected_action": "request_clarification",
    "expected_trajectory": ["start", "route_to_sales_agent", "ask_for_clarification", "end"],
    "category": "Ventas"
  }
]
Gestión y versionado de datasets
Los datasets no son estáticos; evolucionan con el agente. Es crucial tener un sistema para gestionarlos y versionarlos, idealmente junto con el código del agente.
- Control de versiones: Almacenar los datasets en un sistema de control de versiones (ej. Git) o un sistema de gestión de datos versionado. Esto permite rastrear cambios, revertir a versiones anteriores y asegurar la reproducibilidad de las evaluaciones.
- Separación de datasets: Mantener datasets separados para diferentes propósitos: entrenamiento (si aplica), validación y prueba. Para LangGraph, el foco principal es el dataset de prueba (test set).
- Automatización: Integrar la carga y ejecución de pruebas con los datasets en el pipeline de CI/CD. Esto asegura que cada cambio en el agente se evalúe automáticamente contra el conjunto de pruebas actual.
- Documentación: Documentar la metodología de creación del dataset, las directrices de anotación y cualquier suposición hecha durante su construcción. Esto es vital para la sostenibilidad y el mantenimiento a largo plazo.
Aplicación práctica: Construyendo tu primer dataset
Para el lunes, enfócate en el agente LangGraph más crítico de tu proyecto actual. Sigue estos pasos para iniciar tu dataset de prueba:
- Define los 5-10 escenarios clave: Identifica las interacciones más comunes y las más críticas que tu agente debe manejar. Piensa en el 'happy path' y en al menos dos 'failure paths' o casos borde.
- Crea 20-30 ejemplos de entrada/salida: Para cada escenario, genera 2-3 variaciones de la consulta de entrada y su respuesta esperada. Asegúrate de incluir ejemplos que ejerciten diferentes ramas de tu grafo.
- Estructura tu dataset: Utiliza un archivo JSON o CSV con los campos
input_query,expected_output,expected_action(si aplica) ycategory. Asigna untest_case_idúnico a cada ejemplo. - Revisa con un colega: Pide a un compañero que revise tus ejemplos y las salidas esperadas. Una perspectiva externa puede revelar sesgos o lagunas en tu diseño.
Este primer dataset, aunque pequeño, será la base para las evaluaciones futuras y te permitirá empezar a medir el rendimiento de tu agente de manera estructurada.
No hay comentarios por ahora.
para ser el primero en comentar.