Monitoreo y depuración de workflows
Esta lección aborda el monitoreo y la depuración de workflows en n8n. Se cubrirán las herramientas y estrategias para identificar y resolver problemas, asegurando la operación continua y eficiente de las integraciones en entornos de producción. El objetivo es proporcionar un enfoque estructurado para la gestión de errores y el mantenimiento.
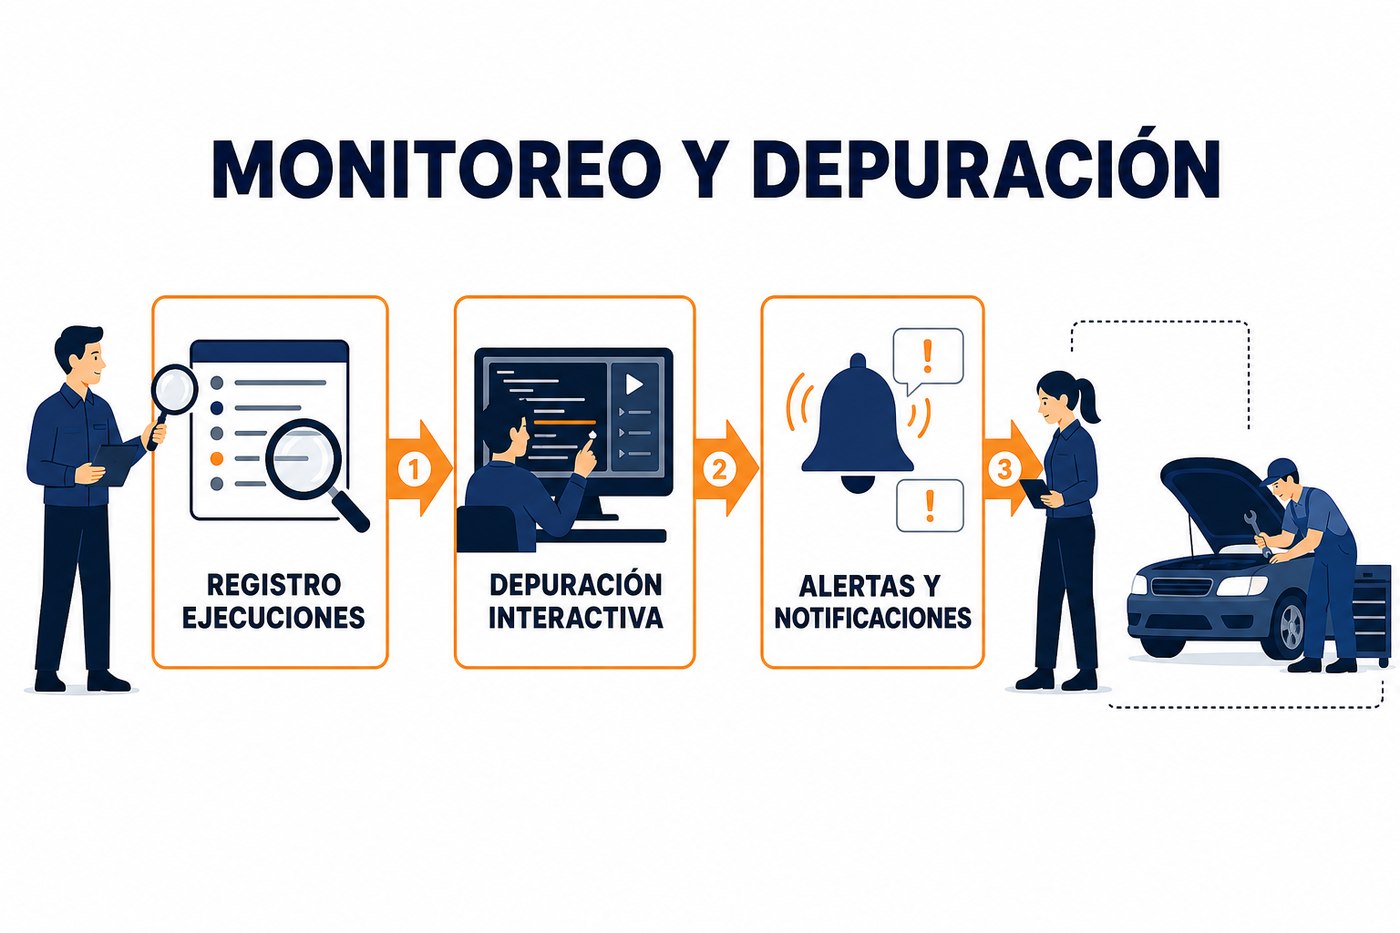
Registro de ejecuciones (Execution Log)
El registro de ejecuciones es la herramienta principal para monitorear el comportamiento de los workflows en n8n. Cada vez que un workflow se dispara, se genera una entrada en este registro. Permite visualizar el flujo de datos, los resultados de cada nodo y los posibles errores.
Para acceder al registro, navega a la sección 'Executions' en la interfaz de n8n. Aquí encontrarás una lista de todas las ejecuciones, con su estado (éxito, fallo, en ejecución), la fecha y la duración. Al seleccionar una ejecución específica, se despliega una vista detallada que muestra:
- Diagrama del workflow: Muestra el camino que tomaron los datos a través de los nodos.
- Datos de entrada y salida por nodo: Permite inspeccionar el JSON que entra y sale de cada nodo, facilitando la identificación de transformaciones incorrectas o datos inesperados.
- Errores específicos: Si un nodo falla, se resalta y se proporciona el mensaje de error correspondiente, a menudo con un stack trace que indica la línea de código o la función que causó el problema.
Es fundamental revisar el registro de ejecuciones de forma periódica, especialmente después de desplegar cambios o si se reportan inconsistencias en los sistemas integrados. La capacidad de 'Re-run' una ejecución fallida es útil para probar soluciones rápidamente sin esperar un nuevo disparador.
Depuración interactiva y modo de prueba
Antes de desplegar un workflow a producción, es crucial depurarlo en un entorno controlado. n8n ofrece un modo de prueba que simula una ejecución real sin afectar los sistemas externos, a menos que se configure explícitamente para ello.
- Modo de prueba (Test Workflow): Al activar el botón 'Test Workflow' en el editor, n8n ejecuta el workflow y muestra los datos en tiempo real a medida que fluyen entre los nodos. Esto permite inspeccionar los datos de entrada y salida de cada nodo de forma interactiva.
- Ejecución de nodos individuales: Es posible ejecutar nodos específicos de forma aislada para verificar su comportamiento. Esto es útil para probar la lógica de transformación de datos o la conectividad con una API sin ejecutar todo el workflow.
- Datos de ejemplo: Para workflows que se disparan por webhooks, se pueden enviar datos de ejemplo directamente desde el editor de n8n o utilizando herramientas como Postman para simular el disparador y observar el flujo.
Siempre depura con datos representativos de producción, incluyendo casos límite o valores nulos. La depuración con solo datos 'felices' no revela la robustez real del workflow.
Alertas y notificaciones de error
Para workflows en producción, no es práctico monitorear el registro de ejecuciones constantemente. n8n permite configurar alertas para notificar sobre fallos críticos.
- Nodos de notificación: Se pueden añadir nodos como 'Email', 'Slack', 'Microsoft Teams' o 'Telegram' al final de un error workflow (visto en lecciones anteriores) para enviar alertas automáticas cuando un workflow principal falla. Esto asegura que el equipo responsable sea notificado de inmediato.
- Configuración de notificaciones globales: En algunas configuraciones de n8n (dependiendo de la versión y el modo de despliegue), se pueden establecer notificaciones globales para fallos de workflows. Consulta la documentación oficial de n8n para tu versión específica, ya que estas opciones pueden variar o requerir configuraciones a nivel de servidor.
La clave es que las notificaciones sean accionables. Deben incluir información suficiente para que el equipo de soporte pueda identificar el workflow, el tipo de error y, si es posible, un enlace directo a la ejecución fallida en n8n.
Optimización y rendimiento
El monitoreo no solo se trata de errores, sino también de rendimiento. Un workflow que funciona pero es lento puede impactar negativamente los sistemas integrados.
- Duración de las ejecuciones: El registro de ejecuciones muestra la duración total de cada ejecución. Identifica workflows que toman un tiempo excesivo. Esto podría indicar cuellos de botella en nodos específicos, llamadas a APIs lentas o procesamiento ineficiente de grandes volúmenes de datos.
- Uso de recursos: En despliegues auto-hospedados, monitorea el uso de CPU y memoria del servidor de n8n. Un consumo elevado podría ser señal de workflows mal optimizados o de la necesidad de escalar los recursos del servidor.
- Batching y concurrencia: Si un workflow procesa muchos ítems, considera usar técnicas de batching para reducir el número de llamadas a APIs externas. Para tareas independientes, la configuración de concurrencia en los nodos puede mejorar el rendimiento, pero debe usarse con precaución para no sobrecargar los sistemas de destino.
Aplicación práctica: Estrategia de monitoreo post-despliegue
Una vez que un workflow ha sido desplegado a producción, la estrategia de monitoreo debe ser proactiva. Aquí hay pasos concretos para implementar el lunes:
- Configura alertas de error: Para cada workflow crítico, asegúrate de que exista un error workflow asociado que envíe notificaciones a un canal de Slack o correo electrónico del equipo de soporte. Incluye el nombre del workflow, el ID de la ejecución y el mensaje de error. Por ejemplo, utilizando un nodo 'Slack' con un mensaje como:
Workflow fallido: {{ $workflow.name }} (ID: {{ $execution.id }}). Error: {{ $error.message }}. - Revisa el registro de ejecuciones diariamente: Dedica 15 minutos cada mañana a revisar las ejecuciones de los workflows más críticos. Busca estados 'Failed' o 'Stopped'. Si el volumen es muy alto, enfócate en los que tuvieron fallos recientes.
- Establece umbrales de rendimiento: Identifica los workflows que no deben exceder un cierto tiempo de ejecución (ej. 5 minutos). Si una ejecución supera este umbral, investiga la causa. Esto puede requerir un monitoreo externo o un nodo de 'If' dentro del workflow para verificar la duración y alertar.
- Documenta los errores comunes: Crea una base de conocimiento interna con los errores más frecuentes, sus causas y las soluciones aplicadas. Esto agiliza la resolución de problemas futuros y capacita al equipo de soporte.
- Programa revisiones periódicas: Cada mes, realiza una auditoría de todos los workflows en producción. Verifica que sigan siendo relevantes, que no haya nodos obsoletos y que la lógica sea eficiente. Esto es parte del ciclo de vida del desarrollo y mantenimiento.
No hay comentarios por ahora.
para ser el primero en comentar.