Optimización de Rendimiento de Workflows en Producción
La optimización del rendimiento en n8n es crucial para escalabilidad y eficiencia operativa. Esta lección cubre estrategias para identificar cuellos de botella y aplicar mejoras en workflows complejos o de alto volumen, asegurando que los procesos automatizados operen de forma óptima en producción.
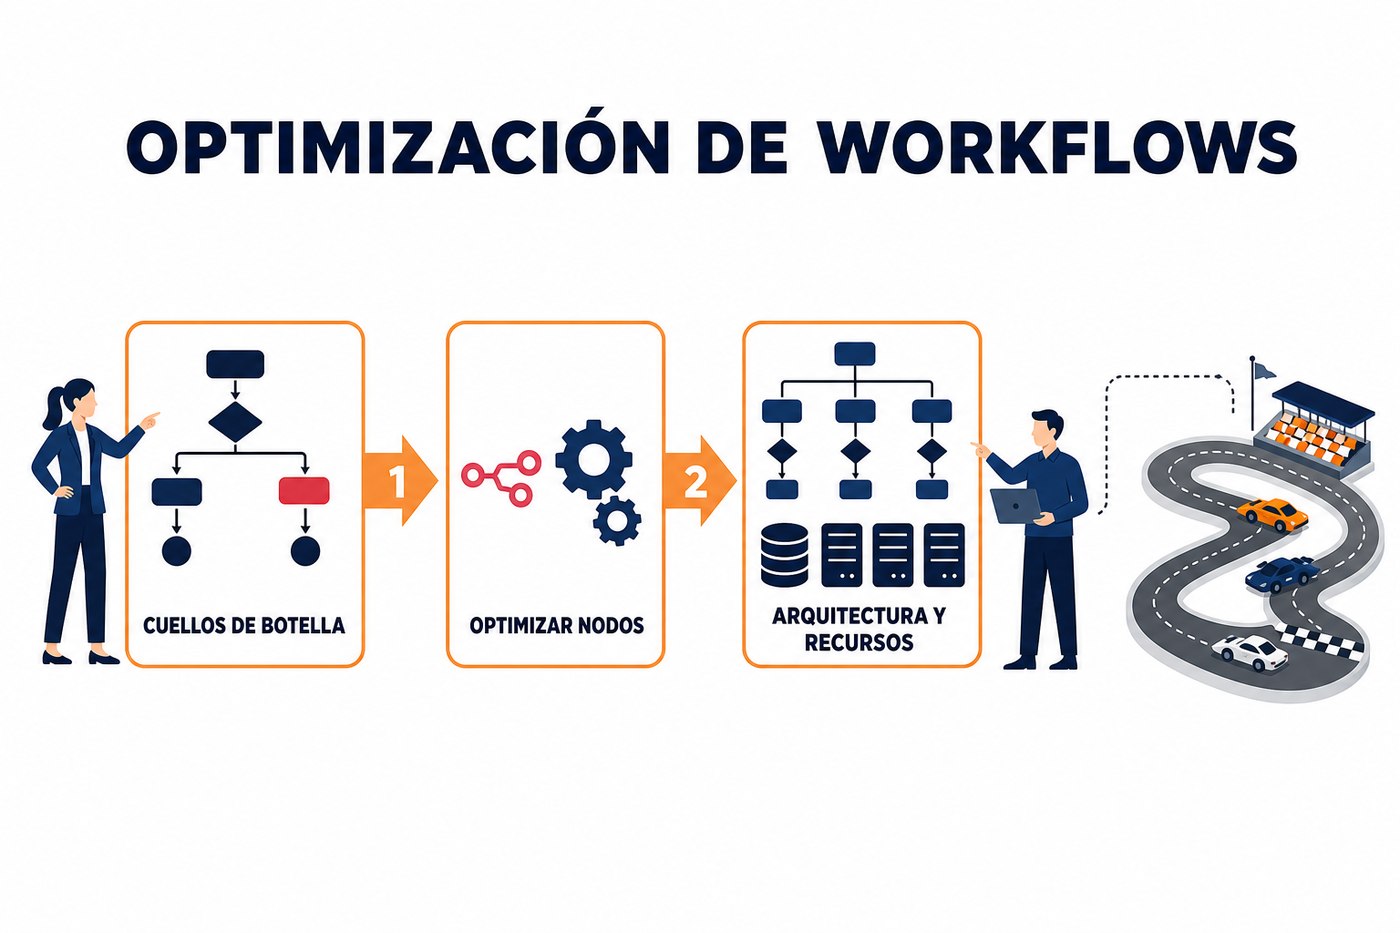
Identificación de Cuellos de Botella
Antes de optimizar, es necesario saber qué parte del workflow es ineficiente. Los cuellos de botella pueden ser causados por operaciones de E/S lentas, procesamiento intensivo, límites de API externas o un diseño ineficiente del workflow. n8n proporciona herramientas para la observación, pero la correlación de datos es responsabilidad del ingeniero.
- Logs de Ejecución: Revisar los logs detallados de cada ejecución de workflow. n8n registra el tiempo de inicio y fin de cada nodo, lo que permite identificar nodos con tiempos de ejecución desproporcionados.
- Monitoreo de Recursos del Servidor: Utilizar herramientas de monitoreo del sistema operativo (
top,htop,GrafanaconPrometheus) para observar el uso de CPU, memoria, disco y red durante las ejecuciones. Un pico constante en CPU o memoria durante la ejecución de un nodo específico puede indicar un problema de procesamiento. - Tiempos de Respuesta de API Externas: Si el workflow interactúa con APIs de terceros, medir sus tiempos de respuesta. Un nodo que espera una respuesta de una API lenta no es un problema de n8n, sino de la dependencia externa. Esto requiere coordinación con los proveedores de esas APIs.
- Historial de Ejecuciones: n8n mantiene un historial de todas las ejecuciones. Analizar las tendencias de duración de workflows a lo largo del tiempo. Un incremento gradual puede indicar degradación del rendimiento.
Estrategias de Optimización de Nodos
La optimización a nivel de nodo se centra en reducir el tiempo y los recursos que cada operación consume. Esto impacta directamente la duración total del workflow.
- Procesamiento por Lotes (Batch Processing): En lugar de procesar elementos uno por uno, agruparlos y enviarlos en un solo llamado a una API o a una base de datos. Muchos nodos de n8n (HTTP Request, Database) soportan el envío de múltiples elementos. Esto reduce la sobrecarga de conexiones y autenticaciones.
- Filtrado Temprano: Aplicar filtros al inicio del workflow para reducir la cantidad de datos que se procesarán en nodos posteriores. Menos datos significan menos iteraciones y menor consumo de recursos.
- Uso Eficiente de Expresiones: Las expresiones complejas pueden consumir CPU. Simplificarlas o pre-calcular valores cuando sea posible. Evitar bucles anidados o lógica excesivamente compleja dentro de una expresión.
- Manejo de Errores: Un manejo de errores robusto es esencial, pero los reintentos excesivos o la lógica de recuperación ineficiente pueden consumir tiempo y recursos. Configurar límites de reintentos y estrategias de backoff adecuadas.
- Almacenamiento Temporal: Para datos que se usan repetidamente en un workflow, considerar almacenarlos temporalmente en variables de workflow o en una base de datos en memoria (ej. Redis) si el volumen lo justifica, en lugar de recuperarlos de una fuente externa en cada iteración.
Optimización a Nivel de Workflow y Arquitectura
Las decisiones de diseño del workflow y la arquitectura de n8n tienen un impacto significativo en el rendimiento general.
- División de Workflows: Workflows muy largos o con múltiples ramas independientes pueden dividirse en workflows más pequeños y especializados. Utilizar el nodo 'Execute Workflow' para encadenarlos. Esto mejora la legibilidad, facilita la depuración y permite que partes del proceso se ejecuten de forma asíncrona o en diferentes workers.
- Modo Cola (Queue Mode): Configurar n8n en modo cola con workers (ej. con Redis como backend) permite la ejecución concurrente de múltiples workflows. Esto es fundamental para cargas de trabajo de alto volumen. Cada worker puede procesar una ejecución de workflow de forma independiente, distribuyendo la carga.
- Escalabilidad Horizontal: Añadir más workers a la configuración de n8n en modo cola. Esto aumenta la capacidad de procesamiento paralelo. Monitorear el uso de recursos de los workers para determinar cuándo es necesario escalar.
- Base de Datos Optimizada: Asegurarse de que la base de datos de n8n (PostgreSQL es la recomendada para producción) esté correctamente configurada y optimizada. Índices adecuados, mantenimiento regular y recursos suficientes para la base de datos son críticos para el rendimiento de n8n, especialmente con un alto volumen de ejecuciones y logs.
La optimización prematura es una fuente común de complejidad innecesaria. Identifique el cuello de botella real antes de aplicar cualquier cambio. Un workflow que funciona bien para 100 ejecuciones al día no requiere la misma optimización que uno con 10,000.
Gestión de Recursos y Concurrencia
El control sobre cómo n8n utiliza los recursos y gestiona las ejecuciones concurrentes es clave para mantener la estabilidad y el rendimiento.
- Límites de Concurrencia: n8n permite establecer límites de concurrencia para workflows individuales o para el sistema en general. Esto evita que un workflow consuma todos los recursos disponibles y afecte a otros. Se configura mediante variables de entorno como
N8N_METRICS_MAX_EXECUTION_TIMEOUTo en la configuración del worker. - Reintentos y Backoff: Implementar estrategias de reintento con backoff exponencial para llamadas a APIs externas. Esto evita saturar los servicios externos y permite que se recuperen de cargas temporales. n8n ofrece opciones de reintento en el nodo HTTP Request y en el manejo de errores.
- Cacheo: Si los datos de APIs externas no cambian con frecuencia, implementar una capa de caché (ej. Redis) para reducir el número de llamadas a la API y acelerar la recuperación de datos. Esto debe hacerse con criterio para evitar datos obsoletos.
Aplicación Práctica: Qué Hacer el Lunes
- Revisar Logs de Workflows Críticos: Seleccione los 3-5 workflows más importantes o de mayor volumen en producción. Revise sus logs de ejecución en n8n y en el sistema de monitoreo de logs (ej. ELK Stack) para identificar nodos que consistentemente tardan más de lo esperado. Anote los tiempos promedio de cada nodo.
- Monitorear Recursos del Servidor: Durante un período de carga pico, observe el uso de CPU, memoria y E/S de disco de sus servidores n8n y de la base de datos. Correlacione los picos de uso con las ejecuciones de los workflows identificados en el paso anterior.
- Identificar Oportunidades de Procesamiento por Lotes: Revise los workflows donde se procesan muchos elementos individualmente (ej. llamadas HTTP en un bucle). Determine si es posible agrupar estos elementos y realizar una sola llamada por lotes. Consulte la documentación de la API externa para ver si soporta operaciones por lotes.
- Evaluar División de Workflows: Si tiene workflows muy extensos o con lógica compleja e independiente, analice si pueden dividirse en componentes más pequeños. Planifique cómo se encadenarían usando el nodo 'Execute Workflow' y si esto permitiría una ejecución más eficiente o paralela.
No hay comentarios por ahora.
para ser el primero en comentar.