Planificación de Escalabilidad y Resiliencia con NIM
Esta lección aborda el diseño de arquitecturas de despliegue con NVIDIA NIM para asegurar escalabilidad horizontal y resiliencia. Se enfoca en la implementación de estrategias con orquestadores de contenedores para manejar la carga y los fallos de manera eficiente, optimizando la disponibilidad y el rendimiento de los servicios de inferencia.
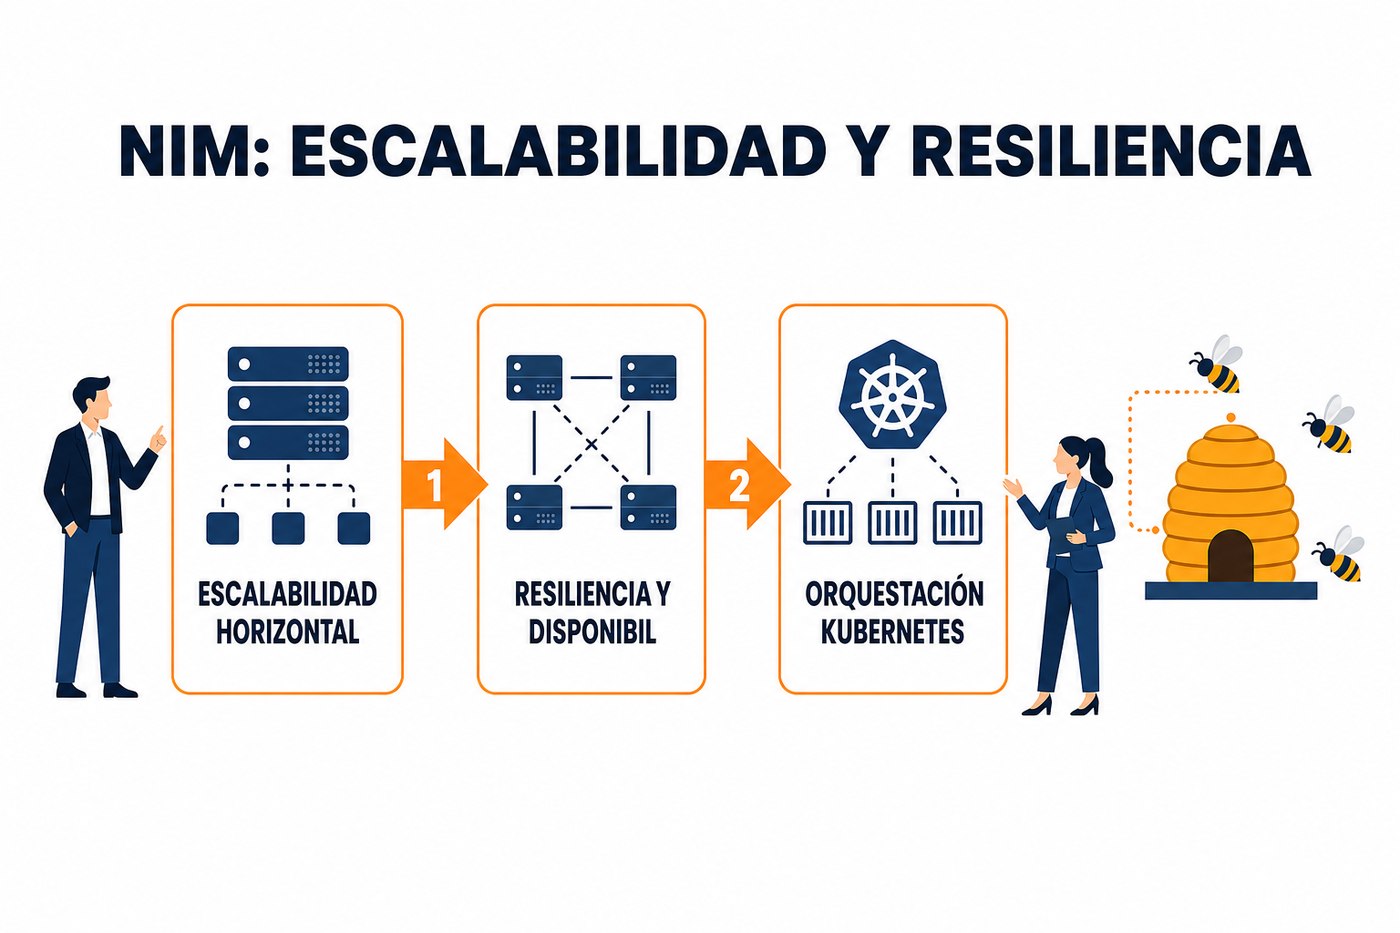
Principios de Escalabilidad Horizontal con NIM
La escalabilidad horizontal es crítica para los servicios de inferencia que experimentan cargas de trabajo variables o crecientes. Con NVIDIA NIM, esto se logra desplegando múltiples instancias del microservicio de inferencia en diferentes nodos o pods. Un orquestador de contenedores como Kubernetes es el mecanismo estándar para gestionar este tipo de despliegue. Cada instancia de NIM puede atender solicitudes de inferencia de forma independiente, distribuyendo la carga y aumentando la capacidad total del sistema.
Para escalar horizontalmente, es necesario considerar los siguientes factores:
- Métricas de Carga: Monitorear el uso de GPU, la latencia de inferencia y el throughput es fundamental. Estas métricas informan cuándo es necesario escalar (añadir instancias) o desescalar (reducir instancias).
- Autoescalado: Configurar políticas de autoescalado en el orquestador que ajusten el número de réplicas de NIM basándose en umbrales de recursos (CPU, memoria, GPU) o métricas personalizadas (por ejemplo, solicitudes por segundo).
- Distribución de Carga: Un balanceador de carga es indispensable para distribuir las solicitudes entrantes de manera equitativa entre las instancias de NIM disponibles, evitando cuellos de botella y maximizando la utilización de recursos.
- Estado Sin Sesión (Stateless): Los microservicios NIM están diseñados para ser stateless, lo que facilita su escalado horizontal. Cada solicitud de inferencia es independiente, permitiendo que cualquier instancia disponible la procese sin depender del estado de solicitudes anteriores.
Diseño para la Resiliencia y Alta Disponibilidad
La resiliencia asegura que el servicio de inferencia continúe operativo incluso frente a fallos de componentes. Con NIM, esto implica diseñar el despliegue para tolerar fallos de nodos, pods o incluso zonas de disponibilidad. Los orquestadores de contenedores proporcionan herramientas nativas para lograr alta disponibilidad.
- Múltiples Réplicas: Desplegar siempre al menos dos réplicas de cada microservicio NIM. Si una réplica falla, el orquestador puede redirigir el tráfico a las réplicas saludables y, si está configurado, intentar reiniciar o reemplazar la réplica fallida.
- Distribución en Zonas de Disponibilidad: En entornos de nube, distribuir las réplicas de NIM en diferentes zonas de disponibilidad protege contra fallos a nivel de centro de datos. Esto requiere una configuración adecuada del orquestador y la infraestructura subyacente.
- Sondas de Salud (Health Probes): Configurar liveness y readiness probes en Kubernetes para cada pod de NIM. Las liveness probes detectan si una instancia está funcionando correctamente y, si falla, el orquestador la reinicia. Las readiness probes indican si una instancia está lista para recibir tráfico, evitando que el balanceador de carga envíe solicitudes a pods que aún están inicializándose o que no pueden procesar inferencias.
- Tolerancia a Fallos de Nodos: El orquestador debe ser capaz de reprogramar pods de NIM en nodos saludables si un nodo subyacente falla. Esto requiere que los recursos de GPU sean abstractos y estén disponibles en múltiples nodos.
- Graceful Shutdown: Asegurar que los microservicios NIM puedan terminar de procesar las solicitudes en curso antes de apagarse, evitando la pérdida de inferencias.
Orquestación de Contenedores: Kubernetes para NIM
Kubernetes es la plataforma de facto para la orquestación de contenedores y ofrece las capacidades necesarias para escalar y hacer resilientes los despliegues de NIM. La integración de NVIDIA con Kubernetes, a través de herramientas como el NVIDIA GPU Operator, facilita la gestión de recursos de GPU.
- Deployment: Define el estado deseado para las réplicas de NIM. Kubernetes asegura que el número especificado de réplicas esté siempre en ejecución.
- Service: Proporciona una abstracción estable para acceder a las réplicas de NIM, gestionando el balanceo de carga interno.
- Horizontal Pod Autoscaler (HPA): Ajusta automáticamente el número de réplicas de un Deployment basándose en métricas como el uso de CPU, memoria o métricas personalizadas de GPU.
- Pod Disruption Budget (PDB): Permite especificar el número mínimo de réplicas disponibles durante interrupciones voluntarias (ej. mantenimiento), mejorando la resiliencia.
Ejemplo de configuración básica de un Deployment de NIM en Kubernetes:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nim-inference-deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nim-inference
  template:
    metadata:
      labels:
        app: nim-inference
    spec:
      containers:
      - name: nim-inference-container
        image: nvcr.io/nvidia/nim-llm:latest # Imagen NIM específica
        ports:
        - containerPort: 8000
        resources:
          limits:
nvidia.com/gpu: 1 # Solicita una GPU por podSiempre sobredimensiona la capacidad inicial de GPU en un 10-20% por encima de la demanda pico esperada. El autoescalado es reactivo; tener un colchón reduce la probabilidad de degradación del servicio mientras se aprovisionan nuevas réplicas.
Consideraciones para Despliegues On-Premise y en Nube
Aunque los principios de escalabilidad y resiliencia son los mismos, la implementación varía entre entornos on-premise y en la nube.
| Característica | On-Premise | Nube Pública |
|---|---|---|
| Provisión de GPU | Gestión manual de hardware físico; stock limitado. | Instancias bajo demanda; elasticidad casi ilimitada. |
| Balanceo de Carga | Load balancers de hardware o software (ej. NGINX, HAProxy). | Servicios gestionados (ej. AWS ELB, Azure Load Balancer, GCP Load Balancing). |
| Zonas de Disponibilidad | Múltiples racks o centros de datos; mayor complejidad de red. | Zonas de disponibilidad nativas; configuración simplificada. |
| Monitoreo | Herramientas de monitoreo de infraestructura y aplicaciones (ej. Prometheus, Grafana). | Servicios de monitoreo gestionados (ej. CloudWatch, Azure Monitor, GCP Operations). |
| Costos | Inversión inicial de capital (CAPEX); costos operativos fijos. | Modelo de pago por uso (OPEX); costos variables según la demanda. |
Monitoreo y Ajuste Continuo
La planificación de escalabilidad y resiliencia no termina con el despliegue inicial. Requiere un monitoreo continuo y ajustes basados en el rendimiento real y los patrones de uso. Las métricas clave a monitorear incluyen:
- Uso de GPU: Porcentaje de utilización de la GPU, memoria de GPU utilizada.
- Latencia de Inferencia: Tiempo promedio y percentiles (P95, P99) para las solicitudes de inferencia.
- Throughput: Número de solicitudes de inferencia procesadas por segundo.
- Errores: Tasa de errores en las solicitudes de inferencia.
- Recursos del Nodo: Uso de CPU y memoria de los nodos que alojan los pods de NIM.
Estas métricas deben ser visualizadas en un panel de control (ej. Grafana) y configurar alertas para umbrales críticos. La observación de tendencias permite anticipar necesidades de escalado o identificar cuellos de botella.
Aplicación Práctica: Qué hacer el lunes
Para implementar la escalabilidad y resiliencia con NIM, siga estos pasos:
- Defina los Requisitos: Establezca los objetivos de latencia, throughput y disponibilidad para su servicio de inferencia NIM. Determine la carga máxima esperada y los patrones de tráfico (picos, valles).
- Seleccione el Orquestador: Si no lo tiene, evalúe e implemente Kubernetes (o una alternativa como OpenShift) como su plataforma de orquestación de contenedores. Asegúrese de que el NVIDIA GPU Operator esté instalado y configurado para gestionar las GPU.
- Diseñe el Despliegue Inicial: Cree un manifiesto de Kubernetes (Deployment, Service) para su microservicio NIM con al menos 2-3 réplicas iniciales. Configure las solicitudes y límites de recursos de GPU por pod.
- Configure Sondas de Salud: Añada liveness y readiness probes a su Deployment de NIM para asegurar la detección y recuperación automática de fallos.
- Implemente Autoescalado: Configure un Horizontal Pod Autoscaler (HPA) para su Deployment de NIM, utilizando métricas de uso de GPU o solicitudes por segundo. Defina límites mínimos y máximos de réplicas.
- Establezca Monitoreo y Alertas: Integre su despliegue de NIM con un sistema de monitoreo (ej. Prometheus/Grafana) para recolectar métricas clave. Configure alertas para cuando se superen los umbrales de rendimiento o disponibilidad.
- Pruebe la Resiliencia: Realice pruebas de inyección de fallos (ej. apagar un nodo, eliminar un pod) para verificar que el sistema se recupera automáticamente y que el servicio permanece disponible.
No hay comentarios por ahora.
para ser el primero en comentar.