Dimensionamiento de Cargas de Trabajo para NIM
Estimar la capacidad de GPU para NVIDIA NIM es crucial para la eficiencia operativa y el control de costos. Esta lección detalla las metodologías para dimensionar cargas de trabajo, considerando el modelo, la concurrencia y los objetivos de latencia, para asegurar un despliegue óptimo.
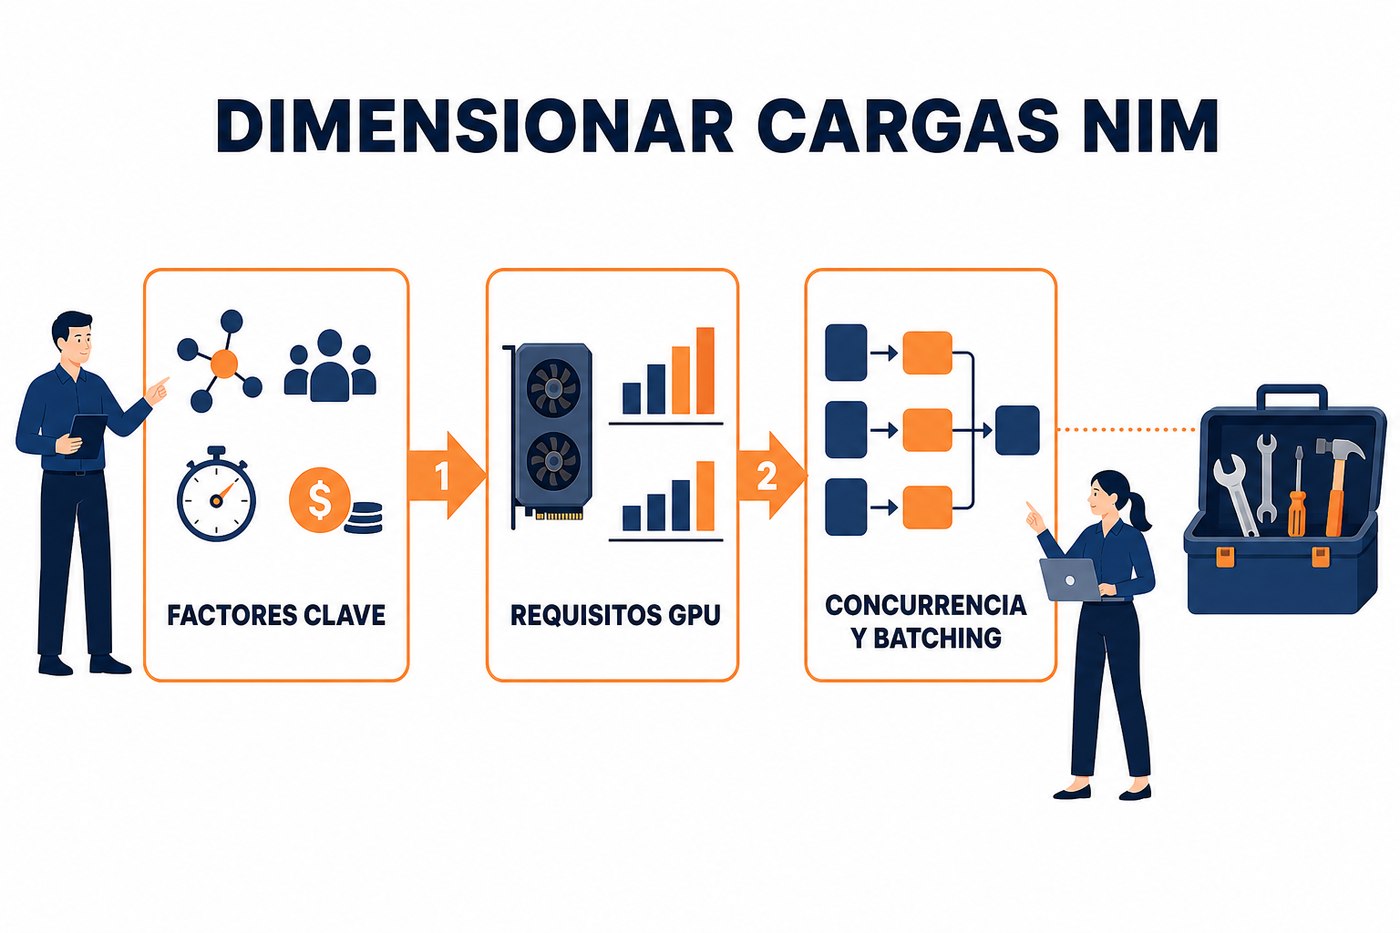
Factores Clave en el Dimensionamiento
El dimensionamiento de la infraestructura para NVIDIA NIM implica equilibrar el rendimiento deseado con la inversión en hardware. Los factores principales a considerar son el tamaño del modelo, la concurrencia esperada y los objetivos de latencia y throughput.
- Tamaño del Modelo (Parámetros y Memoria): Modelos más grandes requieren más memoria de GPU (VRAM) y más capacidad de cómputo. La cantidad de parámetros influye directamente en la cantidad de VRAM necesaria para cargar el modelo y sus activaciones durante la inferencia. Un modelo de 7B (7 mil millones de parámetros) no es lo mismo que uno de 70B.
- Concurrencia Esperada: Número de solicitudes de inferencia que se procesan simultáneamente. Una mayor concurrencia exige más recursos de GPU o la capacidad de procesar lotes (batches) más grandes de manera eficiente.
- Objetivos de Latencia: El tiempo que tarda una solicitud individual en ser procesada desde que llega al microservicio hasta que se devuelve la respuesta. La latencia es crítica para aplicaciones interactivas.
- Objetivos de Throughput: La cantidad total de inferencias que el sistema puede procesar por unidad de tiempo (por ejemplo, inferencias por segundo). Es vital para cargas de trabajo de alto volumen.
Estimación de Requisitos de Memoria de GPU
La VRAM es el recurso más crítico para cargar modelos. Un modelo de lenguaje grande (LLM) requiere VRAM para sus pesos (weights), activaciones, caché KV (Key-Value) para inferencia secuencial y cualquier sobrecarga del sistema operativo o del runtime de NIM. La cuantificación (por ejemplo, FP16 a INT8) reduce la huella de memoria, pero puede afectar la precisión.
Siempre verifique los requisitos de VRAM del modelo específico que va a desplegar. Las estimaciones generales son un punto de partida, pero la implementación real y las optimizaciones del modelo pueden variar significativamente el consumo. Consulte la documentación del modelo o realice pruebas preliminares.
Para un modelo en formato FP16, cada parámetro ocupa 2 bytes. Un modelo de 7B parámetros requeriría aproximadamente 14 GB de VRAM solo para los pesos. A esto se le suma la memoria para activaciones y el caché KV, que puede ser sustancial dependiendo de la longitud de la secuencia de entrada/salida y el tamaño del batch. La cuantificación a INT8 o INT4 puede reducir estos requisitos a la mitad o a un cuarto, respectivamente.
Determinación de la Capacidad de Cómputo (FLOPs)
Más allá de la memoria, la capacidad de cómputo se mide en FLOPs (operaciones de punto flotante por segundo). Las GPUs NVIDIA tienen diferentes capacidades de FLOPs, que determinan qué tan rápido pueden ejecutar las operaciones matemáticas del modelo. Modelos más complejos o con mayor número de capas requieren más FLOPs para mantener la latencia deseada.
Para determinar la capacidad de cómputo necesaria, se recomienda un enfoque iterativo:
- Benchmarking Inicial: Ejecute el modelo en una GPU de referencia con una carga de trabajo representativa (tamaño de batch, longitud de secuencia) para medir la latencia y el throughput inicial.
- Proyección de Carga: Estime la carga máxima esperada en términos de solicitudes por segundo (RPS) y el tamaño promedio de las solicitudes.
- Factor de Utilización: Considere un factor de utilización de GPU objetivo (por ejemplo, 70-80%) para dejar margen ante picos de carga o para futuras expansiones. Evitar la saturación del 100% es clave para la estabilidad y la baja latencia.
Estrategias de Concurrencia y Batching
La concurrencia se gestiona mediante el batching dinámico y la paralelización. El batching consiste en agrupar múltiples solicitudes de inferencia en un solo lote para ser procesadas simultáneamente por la GPU. Esto aumenta el throughput al mantener la GPU ocupada, pero puede introducir latencia adicional si el tamaño del batch es demasiado grande y las solicitudes individuales tienen que esperar a que se complete el lote.
- Batching Dinámico: NVIDIA NIM soporta batching dinámico, donde el microservicio agrupa automáticamente las solicitudes entrantes hasta un tamaño de lote predefinido o hasta que se alcanza un umbral de tiempo. Esto optimiza el uso de la GPU.
- Paralelización de Modelos: Para modelos muy grandes que no caben en una sola GPU, se puede usar la paralelización (model parallelism o tensor parallelism) para distribuir el modelo a través de múltiples GPUs. Esto requiere una configuración más compleja y una interconexión de alta velocidad (NVLink) entre las GPUs.
| Métrica | Impacto en Dimensionamiento | Consideraciones |
|---|---|---|
| Latencia | Determina la velocidad de respuesta individual; baja latencia puede requerir más GPUs o GPUs más potentes. | Crítico para aplicaciones interactivas (ej. chatbots). |
| Throughput | Cantidad total de inferencias por segundo; alto throughput puede beneficiarse de batching y más GPUs. | Crítico para cargas de trabajo de alto volumen (ej. procesamiento de imágenes en lotes). |
| Concurrencia | Número de solicitudes simultáneas; impacta la memoria y el cómputo necesarios. | Afecta la capacidad de servir a múltiples usuarios o procesos a la vez. |
Despliegue On-Premise vs. Nube: Implicaciones en el Dimensionamiento
El entorno de despliegue tiene un impacto directo en cómo se aborda el dimensionamiento.
- On-Premise: Requiere una planificación de capacidad más rigurosa y a largo plazo. La inversión inicial es mayor, pero los costos operativos pueden ser menores a escala. Se debe sobredimensionar ligeramente para acomodar el crecimiento futuro y picos inesperados, ya que la adición de hardware no es instantánea. La compra de GPUs como la NVIDIA L4, L40S o H100 implica una inversión significativa y una vida útil esperada.
- Nube: Ofrece flexibilidad y escalabilidad bajo demanda. Se puede empezar con una configuración mínima y escalar horizontal o verticalmente según las necesidades. Esto permite una optimización de costos al pagar solo por los recursos utilizados. Sin embargo, los costos por hora pueden ser más altos que la amortización de hardware propio a largo plazo para cargas de trabajo constantes y predecibles. La elección de instancias de GPU (ej. AWS P4d, GCP A3, Azure ND A100 v4) debe alinearse con los requisitos de VRAM y FLOPs.
Aplicación Práctica: Qué Hacer el Lunes
Para dimensionar correctamente su despliegue de NVIDIA NIM, siga estos pasos iniciales:
- Identifique el Modelo Específico: Determine el modelo de IA que desplegará (ej. Llama 2 7B, Stable Diffusion XL).
- Estime la VRAM: Consulte la documentación del modelo para sus requisitos de VRAM en el formato deseado (FP16, INT8). Añada un 10-20% de margen para el sistema operativo, caché KV y sobrecargas del runtime de NIM. Si el modelo es muy grande, considere la cuantificación o la paralelización.
- Defina Métricas de Rendimiento: Establezca objetivos claros de latencia (ej. <100ms) y throughput (ej. 100 RPS).
- Realice Pruebas Preliminares: Si es posible, ejecute el modelo en una GPU de prueba (incluso en la nube) con un tamaño de batch de 1 para medir la latencia base. Luego, incremente el tamaño del batch y la concurrencia para observar el throughput y la latencia bajo carga. Utilice herramientas como perf_analyzer de Triton Inference Server (base de NIM) para estas pruebas.
- Calcule la Cantidad de GPUs: Con los datos de VRAM, latencia y throughput, y sus objetivos de concurrencia, podrá estimar cuántas GPUs de un tipo específico (ej. NVIDIA L4, A100) necesitará. Considere la interconexión (NVLink) si requiere múltiples GPUs para un solo modelo grande.
There are no comments for now.
to be the first to leave a comment.