Estrategias de Despliegue: Nube Pública con NIM
El despliegue de NVIDIA NIM en la nube pública permite aprovechar la escalabilidad elástica y la infraestructura gestionada de proveedores como AWS, Azure o Google Cloud. Esta lección detalla las consideraciones operativas y estratégicas para implementar microservicios NIM en estos entornos, optimizando la gestión de recursos.
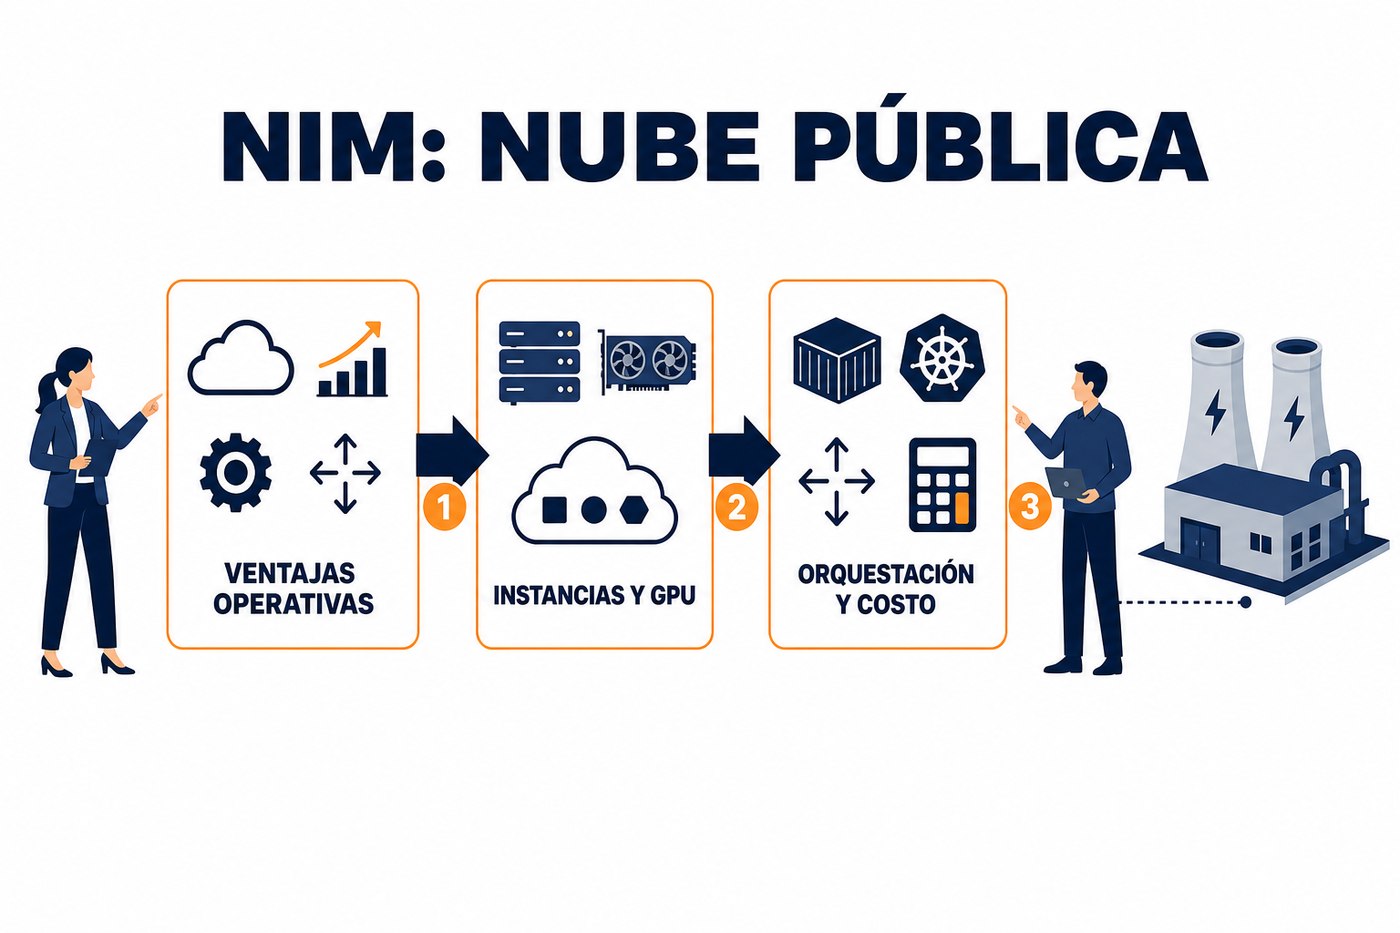
Ventajas Operativas del Despliegue en Nube Pública
La infraestructura de nube pública ofrece ventajas intrínsecas para la operación de cargas de trabajo de inferencia de IA. La principal es la escalabilidad elástica, que permite ajustar dinámicamente los recursos computacionales y de GPU según la demanda. Esto es crítico para modelos de IA que experimentan picos de uso impredecibles o que requieren una capacidad variable a lo largo del tiempo.
Otra ventaja es la reducción de la carga operativa en la gestión de infraestructura física. Los proveedores de nube se encargan del mantenimiento de hardware, la gestión de redes y la seguridad física, permitiendo a los equipos de INT enfocarse en la optimización de los modelos y la lógica de negocio. Esto acelera el tiempo de lanzamiento al mercado de nuevas funcionalidades y reduce los costos operativos asociados con la administración de un centro de datos propio.
- Acceso a hardware especializado: Disponibilidad de GPU de última generación sin inversión de capital inicial.
- Alta disponibilidad y resiliencia: Infraestructura distribuida que minimiza puntos únicos de falla.
- Modelos de pago por uso: Flexibilidad financiera al pagar solo por los recursos consumidos.
- Integración con servicios gestionados: Facilita el monitoreo, logging y orquestación de contenedores (ej. Kubernetes gestionado).
Consideraciones para la Selección de Instancias y GPU
Al desplegar NIM en la nube, la elección de la instancia correcta es fundamental. Los proveedores ofrecen una variedad de tipos de instancias con diferentes configuraciones de GPU, CPU y memoria. Es necesario evaluar las especificaciones de GPU (memoria, núcleos CUDA, Tensor Cores) en relación con los requisitos del modelo de IA a desplegar. Un modelo grande puede requerir una GPU con mayor memoria, mientras que un modelo que necesita alta concurrencia podría beneficiarse de múltiples GPU más pequeñas o de una GPU con mayor capacidad de procesamiento paralelo.
Los microservicios NIM están optimizados para aprovechar las GPU NVIDIA. Al seleccionar una instancia, asegúrese de que la configuración de la GPU sea compatible y que los drivers de NVIDIA estén preinstalados o sean fáciles de instalar. La mayoría de los proveedores de nube ofrecen imágenes de máquina virtual (AMI, VHD, etc.) preconfiguradas con los drivers necesarios para facilitar el despliegue.
No sobredimensione la GPU. Evalúe el consumo de memoria y la latencia objetivo del modelo. Una GPU con el doble de memoria de la necesaria no reduce la latencia de inferencia si el modelo no la usa, pero sí duplica el costo. Priorice la eficiencia.
Orquestación de Contenedores y Escalamiento Elástico
Los contenedores NIM están diseñados para ser desplegados en entornos de orquestación como Kubernetes. En la nube pública, esto se traduce en el uso de servicios gestionados como Amazon EKS, Azure AKS o Google GKE. Estos servicios simplifican la gestión del clúster de Kubernetes, permitiendo a los ingenieros enfocarse en la configuración de los despliegues y los servicios de NIM.
El escalamiento elástico en la nube se implementa a través de autoescaladores. En Kubernetes, el Horizontal Pod Autoscaler (HPA) ajusta el número de réplicas de un pod NIM basándose en métricas como el uso de CPU o la latencia. El Cluster Autoscaler (CA) o Node Auto-provisioning (NAP) ajusta el número de nodos subyacentes (instancias de GPU) en el clúster. La combinación de ambos permite que el sistema se adapte automáticamente a la demanda, aprovisionando y desaprovisionando GPU según sea necesario.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: nim-inference-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: nim-inference-deployment
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
Consideraciones de Costo y Optimización
El modelo de pago por uso de la nube pública puede generar costos significativos si no se gestiona adecuadamente. Las GPU son recursos costosos. Es crucial implementar estrategias de optimización de costos desde el inicio:
- Instancias spot/preemptibles: Utilice estas instancias para cargas de trabajo tolerantes a interrupciones o para inferencia de bajo riesgo, ya que ofrecen descuentos significativos. Sin embargo, no son adecuadas para cargas de trabajo críticas que requieren disponibilidad constante.
- Reservas de instancias: Para cargas de trabajo estables y predecibles, las instancias reservadas pueden reducir los costos en comparación con las instancias bajo demanda.
- Apagado automático: Implemente lógicas para apagar las instancias de GPU cuando no estén en uso, especialmente en entornos de desarrollo o prueba.
- Monitoreo de costos: Utilice las herramientas de monitoreo de costos del proveedor de nube para identificar y optimizar gastos. Establezca alertas de presupuesto.
Comparado con una API externa, el despliegue de NIM en la nube ofrece un mayor control sobre la infraestructura y los datos, pero transfiere la responsabilidad de la gestión de costos al equipo de INT. Las APIs externas tienen un costo por inferencia preestablecido, lo que simplifica el presupuesto, pero a menudo carecen de la flexibilidad y la personalización que NIM proporciona.
Seguridad y Cumplimiento
La seguridad en la nube es una responsabilidad compartida. El proveedor de nube es responsable de la seguridad de la nube (infraestructura física, red, hardware), mientras que el cliente es responsable de la seguridad en la nube (configuración de red, acceso, datos, aplicaciones). Para despliegues NIM, esto implica:
- Control de acceso: Implementar el principio de mínimo privilegio (IAM) para usuarios y servicios que interactúan con los recursos NIM.
- Seguridad de red: Configurar grupos de seguridad, listas de control de acceso de red (NACLs) y redes virtuales privadas (VPC) para aislar los microservicios NIM.
- Cifrado de datos: Asegurar que los datos en tránsito y en reposo estén cifrados, especialmente si se maneja información sensible.
- Gestión de vulnerabilidades: Escanear regularmente las imágenes de contenedores NIM en busca de vulnerabilidades y aplicar parches de seguridad.
Aplicación Práctica: Preparación para Despliegue en Nube
Para el lunes, identifique un microservicio NIM que su equipo esté desarrollando o planeando desplegar. Realice los siguientes pasos:
- Estime los requisitos de GPU: Determine la memoria de GPU necesaria y la capacidad de procesamiento (CUDA Cores, Tensor Cores) para su modelo de IA bajo carga esperada. Consulte la documentación de NVIDIA para el modelo específico si está disponible.
- Seleccione un proveedor de nube: Elija entre AWS, Azure o Google Cloud, basándose en la infraestructura existente de INT, acuerdos de licencia o preferencias de equipo. Investigue los tipos de instancias GPU disponibles y sus costos.
- Diseñe la estrategia de escalado: Defina cómo se escalará el despliegue de NIM (HPA y Cluster Autoscaler) para manejar picos de demanda. Considere umbrales de CPU o latencia para el autoescalado.
- Planifique la optimización de costos: Identifique si su carga de trabajo puede usar instancias spot/preemptibles o si requiere reservas. Establezca un presupuesto inicial y mecanismos de monitoreo.
There are no comments for now.
to be the first to leave a comment.