Optimización de Costos en Despliegues NIM
La optimización de costos en despliegues NVIDIA NIM se centra en el uso eficiente de los recursos de GPU. Implica dimensionar correctamente la infraestructura, gestionar la concurrencia y seleccionar la estrategia de despliegue adecuada para minimizar el gasto operativo sin comprometer el rendimiento de la inferencia.
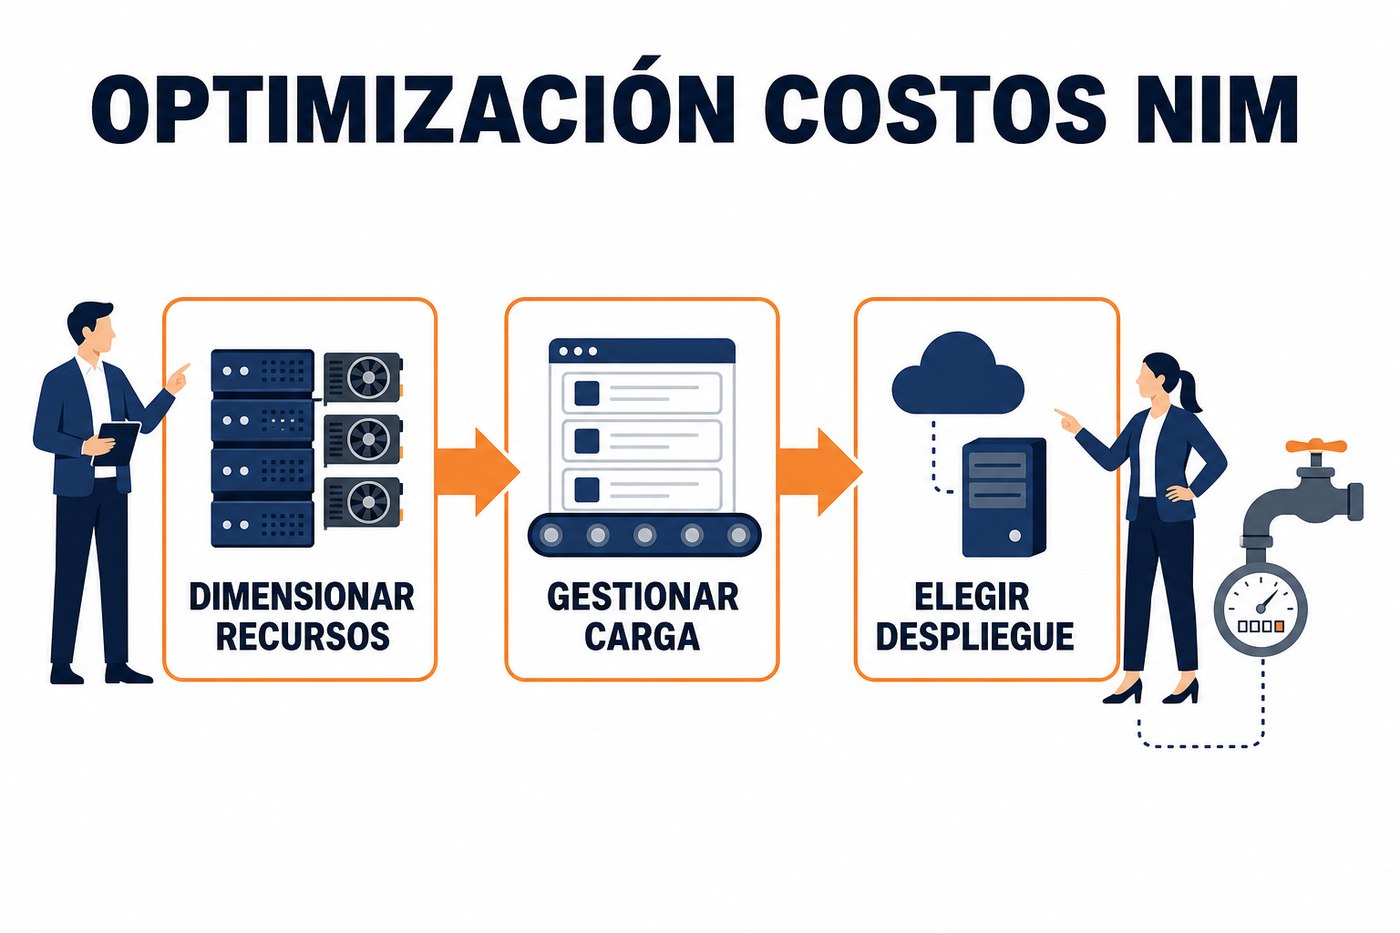
Dimensionamiento de Instancias y Modelos
El dimensionamiento inicial es crítico para evitar el sobredimensionamiento (gasto excesivo) o el subdimensionamiento (problemas de rendimiento y escalado reactivo costoso). Cada modelo de inferencia tiene requisitos de memoria y cómputo específicos que deben ser evaluados. Un error común es asignar una GPU completa a un modelo que solo utiliza una fracción de sus recursos. NVIDIA NIM, al ser un microservicio, permite una mayor granularidad en la asignación de recursos.
Para optimizar, considere lo siguiente:
- Consolidación de modelos: Si múltiples modelos pequeños tienen requisitos de recursos compatibles y patrones de uso similares, pueden desplegarse en la misma GPU, siempre que la memoria y el cómputo total no excedan la capacidad de la tarjeta.
- Modelos grandes: Los modelos que requieren más memoria que la disponible en una sola GPU (por ejemplo, modelos de lenguaje muy grandes) pueden requerir model parallelism o pipeline parallelism. Esto implica dividir el modelo entre varias GPU. Aunque aumenta el costo por el número de GPU, es necesario para la operación del modelo.
- Capacidad de la GPU: Las GPU tienen diferentes capacidades de memoria (VRAM) y unidades de cómputo (CUDA Cores, Tensor Cores). Seleccione la GPU que mejor se ajuste a los requisitos del modelo. No siempre la GPU más potente es la más rentable para todos los casos de uso.
Antes de desplegar, ejecute pruebas de carga con el modelo en una GPU de prueba para medir el uso real de VRAM y el consumo de cómputo bajo la carga esperada. Esto proporciona datos empíricos para el dimensionamiento.
Gestión de la Concurrencia y el Batching
La concurrencia se refiere al número de solicitudes de inferencia que una GPU puede procesar simultáneamente. El batching agrupa múltiples solicitudes de inferencia en un solo lote para procesarlas de manera más eficiente. Ambos son mecanismos clave para maximizar el throughput y reducir el costo por inferencia.
- Tamaño de batch dinámico: NIM permite configurar el tamaño de batch. Un batch más grande generalmente mejora la utilización de la GPU y el throughput total, pero puede aumentar la latencia para solicitudes individuales. El punto óptimo depende del modelo y los requisitos de latencia.
- Concurrencia de solicitudes: Configure el número máximo de solicitudes concurrentes que un microservicio NIM puede manejar. Un valor demasiado bajo subutiliza la GPU; uno demasiado alto puede llevar a colas excesivas y latencia inconsistente.
- Múltiples instancias de NIM: Para modelos que no saturan una GPU con una sola instancia de NIM, o para manejar picos de carga, se pueden desplegar múltiples instancias del microservicio NIM en la misma GPU o en GPUs separadas, balanceando la carga entre ellas. Esto permite una mejor utilización del hardware.
Estrategias de Despliegue: On-premise vs. Nube
La elección entre despliegue local (on-premise) y en la nube impacta directamente los costos operativos.
- Despliegue On-premise: Implica una inversión inicial significativa (CAPEX) en hardware (servidores, GPU, infraestructura de red y energía) y personal. Sin embargo, los costos operativos recurrentes (OPEX) pueden ser menores a largo plazo para cargas de trabajo estables y predecibles. Se tiene control total sobre el hardware y el software.
- Despliegue en la nube: Reduce el CAPEX inicial, ya que se paga por el uso de recursos (OPEX). Ofrece flexibilidad y escalabilidad bajo demanda, ideal para cargas de trabajo variables o picos inesperados. Los costos pueden ser mayores para cargas de trabajo constantes y de alto volumen debido a los márgenes del proveedor de la nube. La elección de la instancia de GPU en la nube es crucial; compare precios por hora y rendimiento entre diferentes proveedores y tipos de GPU.
| Característica | On-premise | Nube Pública |
|---|---|---|
| Inversión inicial | Alta (CAPEX) | Baja (OPEX) |
| Escalabilidad | Limitada, manual | Alta, bajo demanda |
| Control | Total | Parcial |
| Cargas de trabajo | Estables, predecibles | Variables, picos |
| Costos a largo plazo | Potencialmente menores | Potencialmente mayores |
Automatización y Escalado Dinámico
La automatización del escalado es fundamental para optimizar costos, especialmente en la nube. Los microservicios NIM se integran bien con orquestadores de contenedores como Kubernetes, lo que permite un escalado dinámico.
- Horizontal Pod Autoscaler (HPA): En Kubernetes, el HPA puede escalar el número de réplicas de un microservicio NIM basándose en métricas como la utilización de GPU o el número de solicitudes en cola. Esto asegura que se aprovisionen recursos solo cuando son necesarios.
- Cluster Autoscaler: Complementario al HPA, el Cluster Autoscaler ajusta el número de nodos (servidores con GPU) en el clúster de Kubernetes. Si el HPA requiere más réplicas de las que los nodos actuales pueden soportar, el Cluster Autoscaler puede añadir nuevos nodos con GPU.
- Apagado de instancias inactivas: Implemente lógicas para apagar o desaprovisionar instancias de NIM o nodos completos de GPU durante períodos de baja demanda. Esto es particularmente efectivo en la nube para reducir costos cuando no hay tráfico de inferencia.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: nim-inference-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: nim-inference-deployment
  minReplicas: 1
  maxReplicas: 5
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
  # Para GPU, se requeriría un Custom Metric o External Metric si se monitorea uso de GPU directamente
  # o se usa una métrica proxy como solicitudes por segundo.
Aplicación Práctica: Acciones del Lunes
- Audite sus modelos actuales: Revise los requisitos de memoria y cómputo de los modelos que ya están en producción o planeados para NIM. Identifique si hay oportunidades para consolidar modelos en una misma GPU o si algún modelo está sobredimensionado.
- Ejecute pruebas de carga controladas: Antes de desplegar en producción, realice pruebas de carga con diferentes configuraciones de batching y concurrencia. Mida el throughput y la latencia para encontrar el punto óptimo que maximice la utilización de la GPU sin exceder los requisitos de rendimiento.
- Evalúe su estrategia de despliegue: Si está en la nube, revise los patrones de uso de sus GPU. Si la carga es constante y alta, considere si una reserva de instancia o un despliegue on-premise parcial podría ser más rentable. Si la carga es muy variable, asegúrese de que el escalado automático esté configurado y funcionando correctamente.
- Configure monitoreo de costos: Integre las métricas de uso de GPU (VRAM, cómputo) con herramientas de monitoreo de costos de la nube. Cree alertas para detectar patrones de gasto inesperados o subutilización prolongada de recursos.
There are no comments for now.
to be the first to leave a comment.