Acceso y uso de modelos Gemini en Vertex AI
Esta lección detalla cómo acceder y utilizar los modelos Gemini en Vertex AI. Se explican las variantes disponibles (Pro, Ultra) y se establece el criterio para seleccionar el modelo adecuado según el requerimiento funcional y técnico del proyecto. Se cubren los métodos de interacción principales.
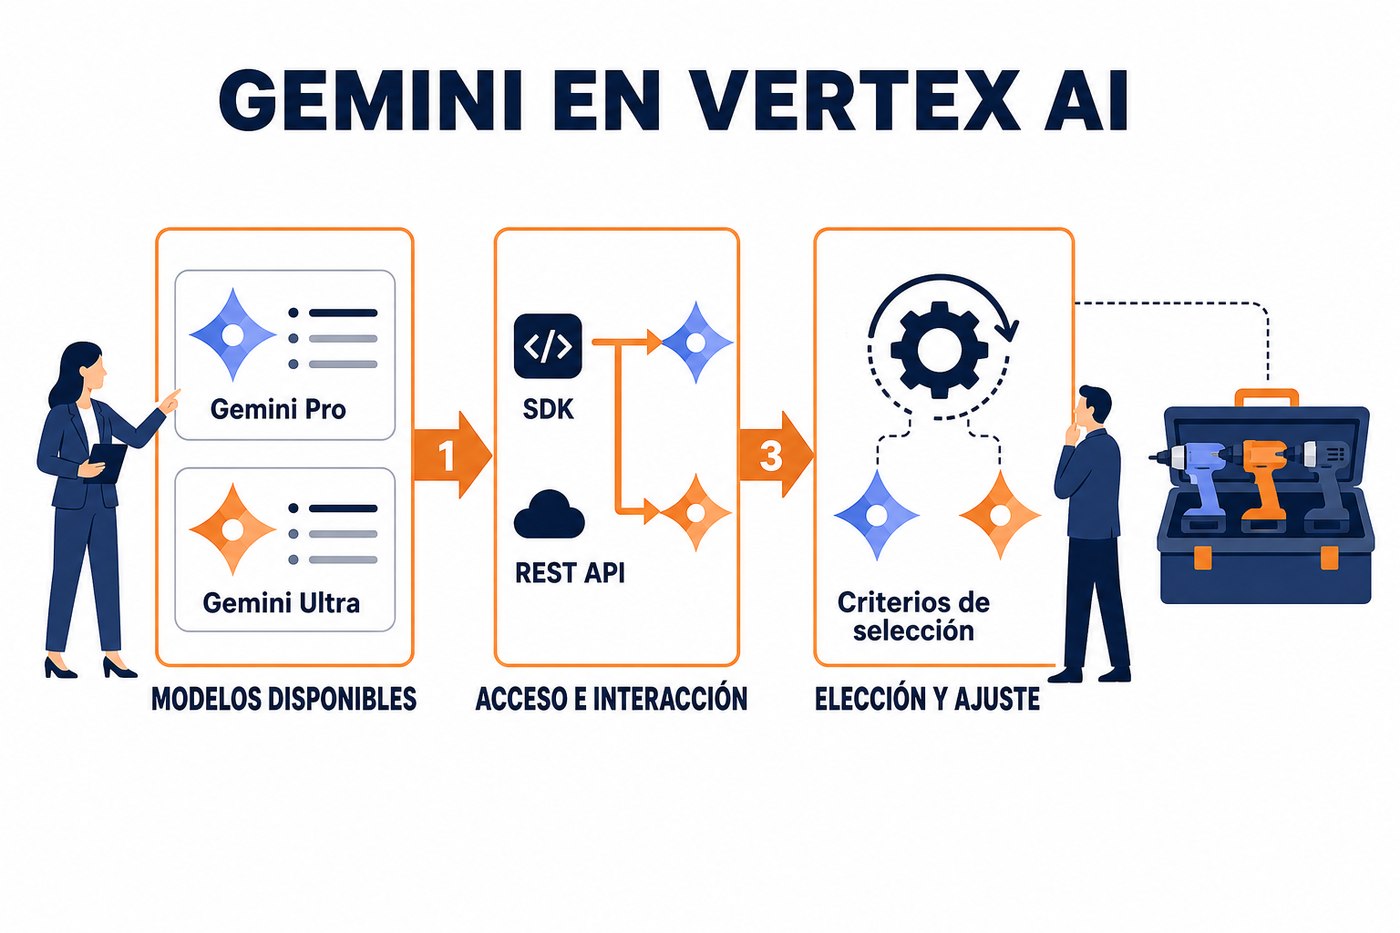
Modelos Gemini disponibles en Vertex AI
Vertex AI ofrece acceso a distintas versiones del modelo Gemini, cada una optimizada para cargas de trabajo específicas. La elección del modelo impacta directamente en el rendimiento, la latencia y los costos de la aplicación. Es fundamental comprender las capacidades de cada variante para una implementación efectiva.
- Gemini 1.0 Pro: Es el modelo base para tareas multimodales generales. Soporta texto, imágenes, audio y video. Ideal para casos de uso que requieren comprensión y generación en múltiples modalidades sin exigencias extremas de razonamiento complejo o latencia mínima. Es la opción más accesible en términos de costo-rendimiento para una amplia gama de aplicaciones.
- Gemini 1.0 Pro Vision: Una variante de Gemini 1.0 Pro optimizada específicamente para entradas visuales (imágenes, video) y texto. Es útil para análisis de contenido visual, descripción de imágenes, y comprensión de documentos escaneados. Su enfoque en la visión lo hace más eficiente para estas tareas que el modelo Pro general.
- Gemini 1.0 Ultra: Diseñado para tareas de alta complejidad que requieren un razonamiento avanzado, comprensión profunda y capacidades multimodales superiores. Ofrece el mejor rendimiento en benchmarks de razonamiento, pero con mayor latencia y costo. Su uso se justifica en aplicaciones críticas donde la precisión y la capacidad de resolver problemas complejos son prioritarias. Actualmente, el acceso a Gemini 1.0 Ultra en Vertex AI es controlado y requiere postulación a través de Google Cloud.
Acceso a los modelos vía Vertex AI SDK y REST API
La interacción con los modelos Gemini en Vertex AI se realiza principalmente a través del Vertex AI SDK para Python o mediante la REST API. Ambos métodos proporcionan las funcionalidades necesarias para enviar prompts, recibir respuestas y gestionar la configuración del modelo. El SDK simplifica la interacción con una abstracción de alto nivel, mientras que la API REST ofrece un control más granular y es adecuada para integraciones con otros lenguajes de programación o sistemas.
Para utilizar el SDK de Python, primero se debe instalar:
pip install google-cloud-aiplatformLuego, se inicializa el cliente y se carga el modelo deseado. La autenticación se gestiona automáticamente si se ejecuta en un entorno de Google Cloud con las credenciales adecuadas, o mediante la configuración de la variable de entorno GOOGLE_APPLICATION_CREDENTIALS.
import vertexai
from vertexai.generative_models import GenerativeModel, Part

PROJECT_ID = "tu-proyecto-id"
LOCATION = "us-central1"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# Cargar el modelo Gemini 1.0 Pro
model = GenerativeModel("gemini-1.0-pro")

# Ejemplo de generación de texto
response = model.generate_content("Explica la fusión nuclear en una frase.")
print(response.text)

# Cargar el modelo Gemini 1.0 Pro Vision
model_vision = GenerativeModel("gemini-1.0-pro-vision")

# Para Gemini 1.0 Ultra, si se tiene acceso:
# model_ultra = GenerativeModel("gemini-1.0-ultra")Verifica siempre la disponibilidad regional de cada modelo. No todos los modelos están disponibles en todas las regiones de Google Cloud simultáneamente, y las versiones pueden variar. Consulta la documentación oficial de Vertex AI para la disponibilidad más reciente.
Configuración de seguridad y parámetros de generación
Los modelos Gemini en Vertex AI permiten ajustar parámetros de generación y configuración de seguridad para controlar la calidad y el contenido de las respuestas. Estos ajustes son críticos para adaptar el comportamiento del modelo a los requisitos específicos de cada aplicación.
- Parámetros de generación:
temperature: Controla la aleatoriedad de las salidas. Valores más altos (ej. 0.8-1.0) producen respuestas más creativas, mientras que valores más bajos (ej. 0.0-0.2) resultan en respuestas más deterministas y enfocadas.max_output_tokens: Establece el número máximo de tokens que el modelo puede generar en una respuesta. Útil para controlar la longitud de las salidas y prevenir respuestas excesivamente largas.top_p: Controla la diversidad del muestreo. El modelo considera solo los tokens cuya probabilidad acumulada sumatop_p.top_k: Limita la selección de tokens a losktokens con mayor probabilidad en cada paso de generación.
- Configuración de seguridad: Permite definir umbrales para filtrar contenido potencialmente dañino en categorías como acoso, incitación al odio, contenido sexualmente explícito y violencia. Esto es esencial para mantener la integridad y seguridad de las aplicaciones que interactúan con usuarios finales. Se configuran mediante el objeto
HarmCategoryyHarmBlockThreshold.
from vertexai.generative_models import GenerationConfig, HarmCategory, HarmBlockThreshold

# Configuración de generación
generation_config = GenerationConfig(
    temperature=0.4,
    max_output_tokens=200,
    top_p=0.8,
    top_k=40
)

# Configuración de seguridad
safety_settings = {
    HarmCategory.HARM_CATEGORY_DANGEROUS_CONTENT: HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
    HarmCategory.HARM_CATEGORY_HATE_SPEECH: HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
    HarmCategory.HARM_CATEGORY_SEXUALLY_EXPLICIT: HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
    HarmCategory.HARM_CATEGORY_HARASSMENT: HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
}

response_tuned = model.generate_content(
    "Escribe un poema sobre la tecnología y el futuro.",
    generation_config=generation_config,
    safety_settings=safety_settings
)
print(response_tuned.text)
Consideraciones para la elección del modelo
La selección del modelo Gemini adecuado debe basarse en una evaluación de los requisitos funcionales, el presupuesto y las expectativas de rendimiento. No siempre el modelo más potente es la mejor opción.
| Criterio | Gemini 1.0 Pro | Gemini 1.0 Ultra |
|---|---|---|
| Complejidad de la tarea | General, multimodal, razonamiento moderado | Alta, razonamiento avanzado, comprensión profunda |
| Latencia | Baja a moderada | Moderada a alta |
| Costo | Menor | Mayor |
| Disponibilidad | Generalmente abierta | Acceso controlado (postulación) |
| Casos de uso | Chatbots, resúmenes, generación de contenido, análisis de imágenes básico | Análisis de datos complejos, investigación, asistencia médica, razonamiento legal |
Inicia siempre con Gemini 1.0 Pro para la mayoría de los casos de uso. Solo escala a Gemini 1.0 Ultra si las pruebas demuestran que Pro no cumple con los requisitos de calidad o complejidad del razonamiento, y si el presupuesto y la latencia lo permiten. Optimizar el prompt antes de cambiar de modelo puede ser más eficiente.
Aplicación práctica: Preparando el entorno para Gemini
Para el lunes, asegúrate de tener un entorno de desarrollo configurado para interactuar con Vertex AI y los modelos Gemini. Esto implica:
- Crear un proyecto en Google Cloud: Si aún no tienes uno, crea un nuevo proyecto en la consola de Google Cloud.
- Habilitar las APIs necesarias: Desde el Dashboard de tu proyecto, busca y habilita las APIs 'Vertex AI API' y 'Cloud AI Platform API'.
- Configurar credenciales: Si trabajas fuera de Google Cloud (ej. tu máquina local), crea una cuenta de servicio, descarga su clave JSON y configura la variable de entorno
GOOGLE_APPLICATION_CREDENTIALSapuntando a ese archivo. - Instalar el SDK de Vertex AI para Python: Ejecuta
pip install google-cloud-aiplatformen tu entorno virtual. - Ejecutar un script de prueba: Utiliza el código de ejemplo proporcionado en esta lección para enviar un prompt simple a
gemini-1.0-proy verificar que puedes recibir una respuesta. Esto confirmará que tu acceso y configuración son correctos.
No hay comentarios por ahora.
para ser el primero en comentar.