Gestión de costos y cuotas en Vertex AI
La gestión de costos y cuotas es crítica para la viabilidad operativa y económica de las soluciones de IA. Esta lección detalla los modelos de precios de Gemini y Vertex AI, y cómo administrar las cuotas de recursos para asegurar el rendimiento y controlar el gasto.
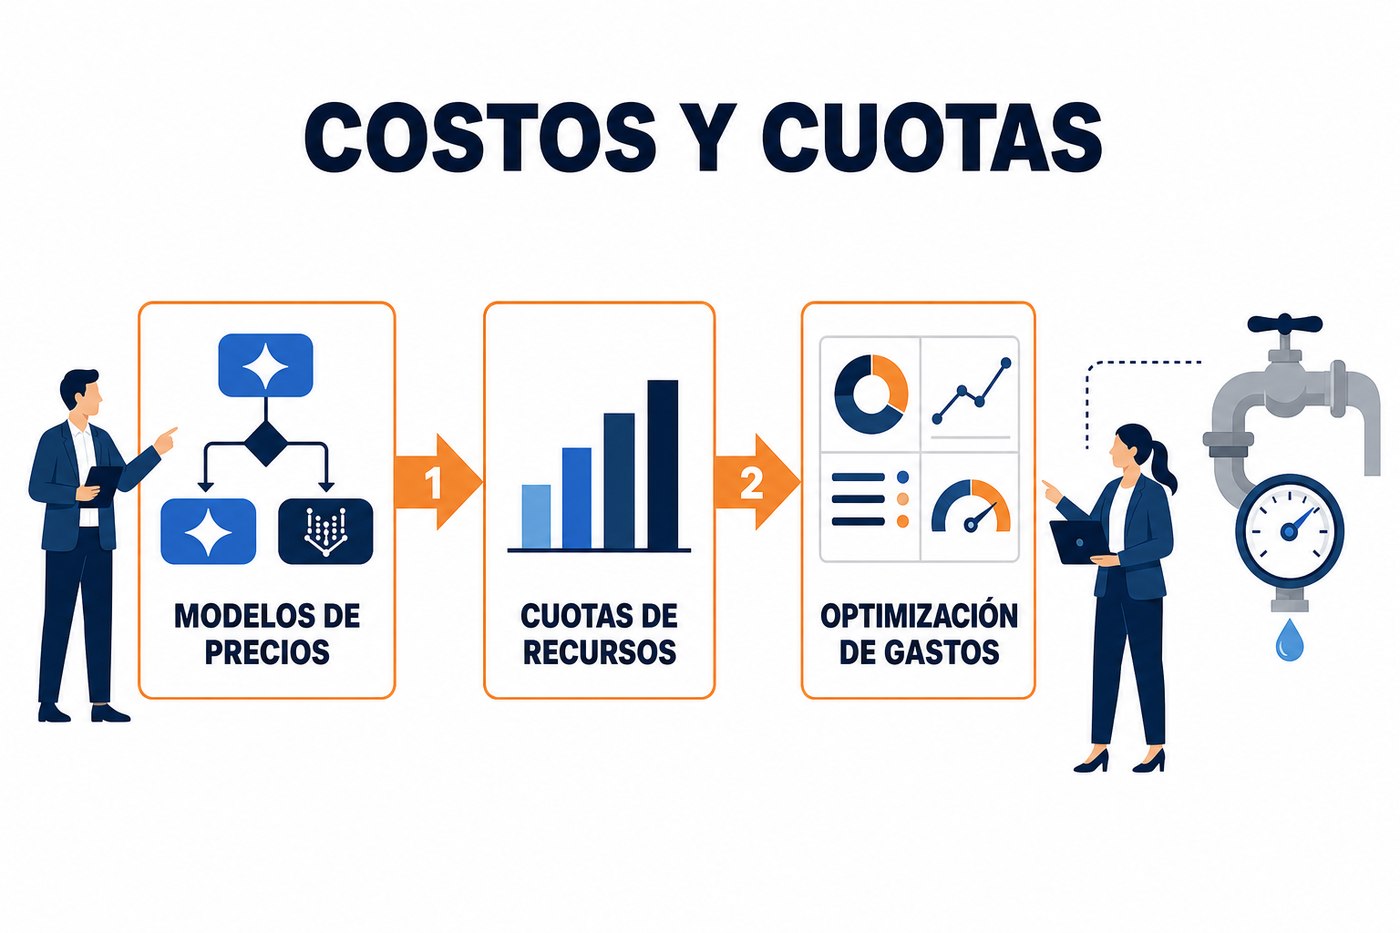
Modelos de costos de Gemini y Vertex AI
Los servicios de IA generativa en Google Cloud, incluyendo Gemini y Vertex AI, se facturan principalmente por el uso de recursos y el volumen de datos procesados. Es fundamental entender que el costo no es solo por la inferencia del modelo, sino también por el almacenamiento, el procesamiento de datos para RAG y el uso de otros servicios auxiliares.
Para Gemini, el modelo de precios se basa en el volumen de caracteres o tokens procesados. Se diferencia entre tokens de entrada (input) y tokens de salida (output), que generalmente tienen tarifas distintas. Los modelos más grandes o con capacidades avanzadas (como Gemini Enterprise) suelen tener un costo por token más alto. Las llamadas a las APIs de multimodalidad (imágenes, audio, video) se facturan por unidad de procesamiento o por duración.
Vertex AI, como plataforma integral, tiene un modelo de costos más granular que incluye:
- Modelos preentrenados y personalizados: Facturación por inferencia (tokens, unidades de procesamiento, etc.) y por el tiempo de entrenamiento de modelos personalizados (horas de GPU/CPU).
- Almacenamiento de datos: Costo por gigabyte al mes para datasets, modelos y artefactos.
- Procesamiento de datos: Costos asociados a servicios como Vertex AI Workbench, Vertex AI Feature Store, o la ingesta y procesamiento de datos para búsqueda vectorial.
- Vertex AI Search y Conversation: Basado en el volumen de consultas (queries), documentos indexados y, en algunos casos, por el tiempo de ejecución de agentes (agent runtime).
Los precios de los modelos de IA generativa pueden variar según la región de Google Cloud. Siempre verifique la página de precios oficial de Google Cloud para su región específica, ya que las tarifas se actualizan periódicamente y los precios de ejemplo son solo ilustrativos.
Cuotas de recursos en Google Cloud
Las cuotas son límites impuestos por Google Cloud sobre el uso de recursos específicos dentro de un proyecto. Su propósito es proteger la infraestructura de Google de abusos, asegurar una distribución equitativa de recursos y ayudar a los usuarios a gestionar sus costos. Para Vertex AI y los modelos generativos, las cuotas son particularmente relevantes y pueden impactar la capacidad de escalar una solución.
Las cuotas más comunes para Vertex AI incluyen:
- Solicitudes por minuto (RPM) o por segundo (RPS) a las APIs de modelos generativos (por ejemplo, generateContent para Gemini).
- Número de endpoints de modelos personalizados desplegados.
- Horas de entrenamiento de GPUs o CPUs.
- Almacenamiento de datasets y modelos.
- Número de índices vectoriales o tamaño de los mismos.
Cada cuota se aplica a nivel de proyecto y puede variar según la región. Es crucial monitorear el uso de cuotas, especialmente en entornos de producción, para evitar interrupciones del servicio.
Monitoreo y gestión de cuotas
La consola de Google Cloud proporciona herramientas para monitorear el uso de cuotas y solicitar aumentos. Para acceder a la información de cuotas:
- Navegue a la sección IAM y administración > Cuotas en la consola de Google Cloud.
- Filtre por servicio (por ejemplo, Vertex AI API o Generative Language API) y por región.
- Revise el uso actual y los límites de cada cuota.
Si una solución requiere superar una cuota existente, se debe solicitar un aumento a través de la misma interfaz. Las solicitudes de aumento se revisan por Google y pueden tardar en ser aprobadas. Es vital planificar con antelación, especialmente para picos de demanda o lanzamientos de producción.
No solicite aumentos de cuota excesivos sin justificación. Un aumento desproporcionado puede generar una revisión más larga y, en algunos casos, ser rechazado. Base sus solicitudes en proyecciones realistas de uso y capacidad de crecimiento.
Optimización de costos en Vertex AI
La optimización de costos es un proceso continuo. Aquí hay estrategias clave:
- Selección del modelo adecuado: Utilice el modelo más pequeño y menos costoso que cumpla con los requisitos de rendimiento. No siempre se necesita el modelo más grande para tareas sencillas.
- Gestión de prompts: Optimice los prompts para ser concisos y eficientes, reduciendo el número de tokens de entrada. Evite la repetición innecesaria.
- Almacenamiento y procesamiento de datos: Implemente políticas de ciclo de vida para datos en Cloud Storage. Utilice servicios de procesamiento de datos eficientes y solo cuando sea necesario.
- Uso de caché: Para respuestas repetitivas o predecibles, implemente una capa de caché para evitar llamadas redundantes a los modelos de IA.
- Monitoreo y alertas: Configure alertas de facturación en Google Cloud para recibir notificaciones cuando el gasto se acerque a umbrales predefinidos. Utilice Cloud Monitoring para rastrear el uso de recursos y detectar anomalías.
- Entrenamiento eficiente: Para modelos personalizados, optimice los hiperparámetros y la arquitectura del modelo para reducir el tiempo de entrenamiento y el uso de recursos de GPU/CPU.
Aplicación práctica: qué hacer el lunes
- Revisar precios: Consulte las páginas de precios de Google Cloud para Vertex AI y los modelos generativos (incluido Gemini) en su región operativa. Entienda la estructura de costos por token, por unidad de procesamiento y por almacenamiento.
- Evaluar cuotas: Acceda a la sección de Cuotas en la consola de Google Cloud para los proyectos donde se implementarán soluciones de IA. Identifique las cuotas relevantes para Vertex AI y los modelos generativos. Verifique los límites actuales y el uso histórico.
- Proyectar demanda: Estime el volumen de solicitudes (RPM/RPS) y el volumen de tokens esperados para las soluciones de IA que se están diseñando. Compare estas proyecciones con las cuotas actuales. Si hay un desfase, planifique la solicitud de aumento de cuotas con tiempo.
- Configurar alertas: Establezca alertas de facturación en Google Cloud para recibir notificaciones cuando el gasto en Vertex AI alcance el 50%, 75% y 90% de su presupuesto mensual proyectado. Esto le permitirá reaccionar proactivamente ante gastos inesperados.
No hay comentarios por ahora.
para ser el primero en comentar.