Estrategias de despliegue y escalabilidad
Esta lección aborda las estrategias de despliegue, monitoreo y escalabilidad para soluciones basadas en Gemini y agentes en Google Cloud. Se enfoca en la operación en producción, asegurando rendimiento, confiabilidad y optimización de costos.
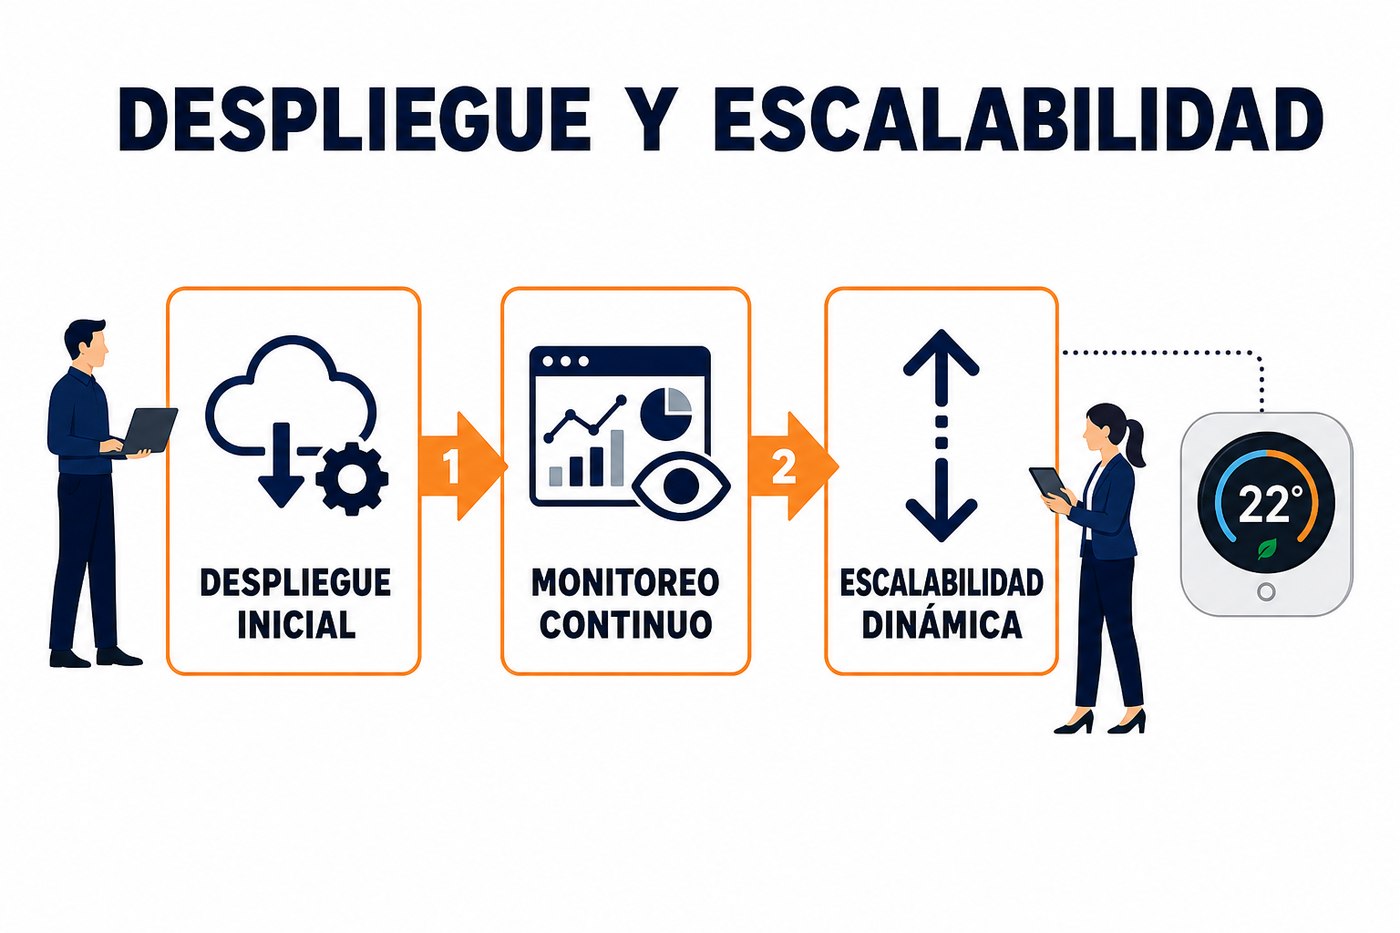
Consideraciones iniciales para el despliegue en producción
Antes de mover una solución de Gemini o agentes a producción, es crucial establecer una base sólida. Esto incluye definir los requisitos de rendimiento, latencia y disponibilidad, así como los objetivos de costo. La arquitectura debe ser resiliente y capaz de manejar cargas esperadas y picos inesperados. La seguridad, el cumplimiento y el gobierno de datos son aspectos no negociables que deben integrarse desde el diseño inicial.
- Definición de SLAs: Establecer acuerdos de nivel de servicio (SLAs) claros para latencia, rendimiento y disponibilidad. Esto guiará las decisiones de infraestructura y monitoreo.
- Estrategia de versiones: Implementar un sistema de control de versiones para modelos, código de agentes y configuraciones. Esto facilita la reversión y el despliegue continuo.
- Gestión de secretos: Utilizar Secret Manager para credenciales de API, claves y otros datos sensibles, evitando su exposición en el código o configuraciones.
- Gestión de dependencias: Asegurar que todas las dependencias de librerías y APIs externas estén controladas y versionadas para evitar conflictos y problemas de compatibilidad.
Estrategias de despliegue y automatización
El despliegue de soluciones de IA en Google Cloud se beneficia de la automatización y las prácticas de CI/CD. Esto asegura consistencia, reduce errores manuales y acelera el ciclo de vida del desarrollo. Para modelos y agentes, se pueden utilizar servicios como Cloud Build y Cloud Deploy.
- Contenedorización con Docker: Empaquetar agentes y lógica de orquestación en contenedores Docker. Esto proporciona un entorno aislado y portable para el despliegue en servicios como Cloud Run, GKE o Vertex AI Endpoints.
- Infraestructura como Código (IaC): Utilizar herramientas como Terraform o Cloud Deployment Manager para definir y provisionar la infraestructura. Esto garantiza la repetibilidad y la consistencia del entorno.
- Despliegue gradual (Canary/Blue-Green): Implementar estrategias de despliegue que permitan probar nuevas versiones con un subconjunto de usuarios antes de una implementación completa. Esto minimiza el riesgo de interrupciones.
# Ejemplo de configuración de Cloud Build para desplegar un agente
steps:
- name: 'gcr.io/cloud-builders/docker'
  args: ['build', '-t', 'gcr.io/$PROJECT_ID/mi-agente:$COMMIT_SHA', '.']
- name: 'gcr.io/cloud-builders/docker'
  args: ['push', 'gcr.io/$PROJECT_ID/mi-agente:$COMMIT_SHA']
- name: 'gcr.io/google.com/cloudsdktool/cloud-sdk'
  entrypoint: gcloud
  args: ['run', 'deploy', 'mi-agente',
         '--image', 'gcr.io/$PROJECT_ID/mi-agente:$COMMIT_SHA',
         '--region', 'us-central1',
         '--platform', 'managed',
'--allow-unauthenticated'] # Ajustar según seguridadSiempre prefiera servicios gestionados como Cloud Run o Vertex AI Endpoints para el despliegue de agentes y modelos. Reducen la carga operativa de mantenimiento de infraestructura y ofrecen escalabilidad automática integrada.
Monitoreo y observabilidad
El monitoreo efectivo es fundamental para asegurar el rendimiento y la salud de las soluciones de Gemini y agentes. Google Cloud ofrece una suite de herramientas para la observabilidad.
- Cloud Monitoring: Recopilar métricas de rendimiento (latencia, uso de CPU/memoria, errores) de los servicios donde se ejecutan los agentes (Cloud Run, GKE, Vertex AI Endpoints). Configurar alertas para desviaciones significativas.
- Cloud Logging: Centralizar los logs de la aplicación y del sistema. Implementar logging estructurado para facilitar la búsqueda y el análisis. Monitorear logs de errores y excepciones.
- Cloud Trace: Para aplicaciones distribuidas y agentes que interactúan con múltiples servicios, Trace permite visualizar el flujo de solicitudes y detectar cuellos de botella en la latencia.
- Monitoreo de modelos en Vertex AI: Utilizar las capacidades de monitoreo de Vertex AI para detectar el drift de datos, el drift de características y la degradación del rendimiento de los modelos subyacentes.
Además del monitoreo técnico, es importante monitorear la calidad de las respuestas de Gemini y el comportamiento de los agentes. Esto puede requerir el registro de interacciones, la implementación de métricas de negocio y la retroalimentación de usuarios.
Estrategias de escalabilidad
La escalabilidad es clave para manejar cargas de trabajo variables y asegurar que la solución pueda crecer con la demanda. Los servicios de Google Cloud están diseñados para la escalabilidad horizontal.
- Escalado automático de servicios:
- Cloud Run: Escala automáticamente el número de instancias de contenedores en función del tráfico. Permite configurar límites mínimos y máximos de instancias, así como concurrencia por instancia.
- GKE: Utilizar Horizontal Pod Autoscaler (HPA) para escalar pods en función del uso de CPU/memoria o métricas personalizadas. Para escalar nodos, usar Cluster Autoscaler.
- Vertex AI Endpoints: Configurar el escalado automático para los endpoints de modelos, especificando el número mínimo y máximo de réplicas.
- Diseño sin estado: Siempre que sea posible, diseñar agentes y servicios para que sean sin estado. Esto facilita el escalado horizontal, ya que cualquier instancia puede manejar cualquier solicitud.
- Bases de datos escalables: Utilizar bases de datos gestionadas y escalables como Cloud Spanner o Cloud Firestore para almacenar estados o datos persistentes de los agentes.
- Almacenes vectoriales optimizados: Para RAG, asegurar que los almacenes vectoriales (como Vertex AI Vector Search) estén configurados para escalabilidad y baja latencia en las consultas.
Optimización de costos y cuotas
La gestión de costos y cuotas es un aspecto crítico de la operación en producción. Gemini y los servicios de Vertex AI tienen modelos de precios basados en el uso.
- Monitoreo de costos: Utilizar Cloud Billing Reports y Cost Management para rastrear el gasto. Configurar alertas de presupuesto para recibir notificaciones cuando el gasto se acerque a un umbral.
- Optimización de recursos:
- Escalado a cero: Configurar Cloud Run para escalar a cero instancias cuando no hay tráfico, reduciendo costos inactivos.
- Instancias con aprovisionamiento justo: Ajustar los límites de CPU y memoria en Cloud Run o GKE para que coincidan con los requisitos reales de la aplicación, evitando el sobreaprovisionamiento.
- Modelos y endpoints: Seleccionar el modelo Gemini adecuado para la tarea (por ejemplo, flash para latencia, pro para complejidad) y optimizar el número de réplicas en los endpoints de Vertex AI.
- Gestión de cuotas: Monitorear las cuotas de API y recursos en Cloud Console. Solicitar aumentos de cuota proactivamente si se anticipa un crecimiento significativo de la demanda. Entender que las cuotas son por proyecto y región.
Aplicación práctica: Qué hacer el lunes
Para aplicar estos conceptos inmediatamente:
- Revisar la arquitectura actual: Si ya tiene una solución en desarrollo, identifique los componentes que no están utilizando servicios gestionados o que no son inherentemente escalables. Planifique la refactorización.
- Implementar CI/CD básico: Configure un pipeline de Cloud Build para automatizar el build y despliegue de un componente clave de su agente o modelo. Comience con un entorno de desarrollo.
- Establecer alertas de monitoreo: Configure alertas en Cloud Monitoring para métricas críticas (errores de API, latencia alta, uso de recursos) en los servicios que alojan sus soluciones de IA. Asegúrese de que las notificaciones lleguen al equipo adecuado.
- Analizar el presupuesto: Revise los informes de facturación de su proyecto actual en Google Cloud. Identifique los principales impulsores de costos y busque oportunidades de optimización, especialmente en servicios de cómputo y almacenamiento.
No hay comentarios por ahora.
para ser el primero en comentar.